Hatte man nicht darüber gesprochen, eine Mapping-Tabelle dafür zu erstellen? @pierre-gilles, du hast doch alles notiert, war diese Möglichkeit denn vorgesehen? 
Genau, wir hatten beschlossen, dass es am besten wäre, das in der Ansicht mit einem spezifischen Typ zu machen.
Beispiel, für den Eco/Gel-Modus ist das so spezifisch, dass kein generischer Button das anzeigen kann (eine Selectbox wäre dafür so unpraktisch ^^)
Aber wenn wir eine Komponente entwerfen, die diesen Typ verwaltet, dann können wir etwas Custom machen, zum Beispiel ein kleines Widget mit 4 Buttons (keine Ahnung), aber wir können uns beim Design austoben!
Und vor allem ist die Internationalisierung super einfach, es ist UI und das wissen wir, wie man UI internationalisiert 
Vorschlag für die Ordnerstruktur:
- core
    - server
        - controllers
        - models
            - user
                - user.create.js
                - user.delete.js
                - user.get.js
                - user.login.js
                - user.schemas.js
                - index.js
            - scenario
        - services
        - integrations
            - zwave
                - package.json
            - sonos
            - …
        - config
            - translations
                - en.json
                - fr.json
        - tests
        - index.js
        - package.json
        - package-lock.json
    - client
        - package.json
        - package-lock.json
- PRIVACY.md
- README.md
- SECURITY.md
Ich habe ein paar Anmerkungen 
-
Warum den Server und den Client in einem Ordner « core » ablegen? Das ist ein bisschen seltsam, finde ich

Für mich gehört « core » zum Server -
Gleiches gilt für die Geschäftslogik im Ordner « models »? Das ist auch ein bisschen seltsam ^^
-
Der Ordner, der die internen Module enthält, sollte nicht « service » heißen? Schließlich nennt man sie in der UI so ^^
-
Und der Übersetzungsordner sollte nicht im Client-Ordner sein? XD
Ich weiß, dass noch nichts feststeht und es nur ein erster Entwurf ist, aber es ist besser, auf einer soliden Basis zu beginnen 
Ich dachte eher an eine Art Fractal-Methode, oder?
So in etwa =>
- server
    - controllers
        - user.controller.js
        ----
    - lib
        - user
           - user.create.js
           - user.get.js
           ----
           - index.js
        ----
        - index.js
    - models
        - user.js
        ----
    - routes
        - user.routes.js
        ----
    - middlewares
    - utils
    - services
        - zwave
        - sonos
        ----
    - test
    - server.js
    - package.json
    - package-lock.json
- client
    - package.json
    - package-lock.json
- PRIVACY.md
- README.md
- SECURITY.md
Ahaha gut gesehen für all diese Bemerkungen. Ich bin im Großen und Ganzen mit allem einverstanden und mag deinen Vorschlag für die Struktur!
Allerdings:
Für mich wird es sowohl auf der Client- als auch auf der Serverseite geben. Zwar wird fast alles auf der Client-Seite sein, aber auf der Serverseite gibt es immer noch Übersetzungen zu machen (z. B. der Titel einer Push-Benachrichtigung, die gesendet werden soll, usw.).
Ein weiterer Hinweis: „models“ ist noch sehr vage, da wir noch nicht wissen, welche Bibliothek wir für das ORM verwenden werden. Wenn wir Sequelize oder Bookshelf verwenden, wird es sehr ähnlich zu den Modellen von Sails.js aussehen. Problem: Ich habe nachgeschaut und diese beiden Bibliotheken scheinen wirklich Kaffee machen zu wollen, und das gefällt mir nicht so gut. Ich habe das Gefühl, dass es dasselbe Chaos wie bei Sails ist. Ich wäre eher bereit, reines Knex zu verwenden. Und die Modelle wären dann einfach Validierungsschemata mit Joi.
Hier ist eine aktualisierte Struktur mit deinen und meinen Anmerkungen.
Hinweis: Ich habe den Ordner „sentence“ hinzugefügt, den ich nach Feature und Sprache organisiert habe, um zu vermeiden, dass etwas so schwerfällig wird wie die langen 120 km langen Dateien, die wir derzeit haben
- server
    - controllers
        - user.controller.js
        ----
    - lib
        - user
           - user.create.js
           - user.get.js
           ----
           - index.js
        ----
        - index.js
    - models
        - user.js
        ----
    - routes
        - user.routes.js
        ----
    - middlewares
    - utils
    - services
        - zwave
        - sonos
        ----
    - test
    - config
        - translations
            - en.json
        - sentences
             - say-hi.en.json
             - say-hi.fr.json
             - weather.en.json
    - server.js
    - package.json
    - package-lock.json
- client
    - package.json
    - package-lock.json
- PRIVACY.md
- README.md
- SECURITY.md
Aaaahhhh gut beobachtet! Daran hatte ich nicht gedacht!
Ja, hier gibt es definitiv einen Nutzen, auch auf Serverseite!
Tatsächlich wird das immer besser sein ^^
Ich weiß nicht, ob es viele Dinge geben wird, die zwischen Server und Client geteilt werden, aber falls doch, könnte es einen Ordner „share“ auf derselben Ebene wie server und client geben, in dem die Übersetzungen, Helfer, gemeinsame Konfigurationsdateien, Konstanten oder andere Dinge gespeichert werden. In meinem Unternehmen während meiner ersten Ausbildung haben wir das in Java gemacht ^^
Das würde dem Client ersparen, die Übersetzungen im Server-Ordner zu suchen, nur aus Prinzip ist das komisch
Ich bin einverstanden, aber ich möchte abwarten, ob wir diese Fälle tatsächlich haben Wir können ohne anfangen und es erstellen, sobald es benötigt wird.
Meinst du, dass wir spezifische APIs für diese Geräte in den Kern integrieren sollen?
Falls ja, darüber haben wir gesprochen und ich glaube, wir hatten beschlossen, uns an Apple zu orientieren, mit ihren spezifischen Funktionen für bestimmte Gerätetypen, um sie besser verwalten zu können
Dein Repo ist nicht schlecht!
@piznel: Tolle Entdeckung dieses Repos! Das gefällt mir sehr
Es stimmt, dass die Abstraktion der Geräte ein Ziel der v3 war, aber meiner Meinung nach nicht weit genug gegangen ist.
Tatsächlich lag der Fehler in der v3 darin, dass ich alles generisch machen wollte, ohne Vorlieben zu haben (das habe ich den Jungs beim Entwickler-Meetup gesagt) und somit ohne Gerätekategorien im Core-Code zu implementieren.
Bisher hatten wir das in kleinerem Maßstab mit einem virtuellen Modul in den Tests (ein Modul, das so ziemlich alles tat und einfach überall Promise.resolve zurückgab ( hier ) )
Ich bin der Meinung, dass für die v4 möglichst viel Testen (sowohl automatisiert als auch lokal) mit virtuellen Gerätekategorien möglich sein sollte, und dass die Module diese Definitionen des Cores erweitern, um im „realen“ Welt bestimmte Funktionen zu implementieren.
Dann bleibt zu sehen, ob man in Bezug auf die HTTP-API eine „generische“ API für die Geräte beibehalten möchte oder ob man nach Kategorien aufteilen möchte:
POST /devicefeature/:id/exec
oder
POST /light/:id/on
POST /light/:id/off
POST /light/:id/luminosity/100
Wir hatten beim Entwickler-Meetup die Apple-Dokumentation gelesen und ihre Definitionen von Klassen sind interessant =>
Edit: Hier sind die Kategorien, die Apple verwaltet:
- Türschlösser
- Ventilatoren
- Garagentoröffner
- Lampen
- Steckdosen
- Thermostate
Das wirft eine sehr gute Frage auf, die hier noch nicht behandelt wurde
Wenn man starke Typisierung verwenden möchte, um bei den Objekten, die man hier und da verschickt, konsistent zu bleiben:
- TypeScript oder kein TypeScript?
Ich habe eine gemischte Meinung dazu. Ich arbeite derzeit mit TypeScript, sowohl in meinem Angestelltenjob als auch als Freelancer. Ich liebe den Flow und die Strenge, die es mit sich bringt (die Autovervollständigung, der Code, der von selbst schreit, wenn man Mist baut, das fängt eine unberechenbare Anzahl von Bugs ab). Ich bin gerade richtig begeistert davon.
Aber:
- es ist eine andere Sprache
- es fügt einen Kompilierungsschritt hinzu
- ich habe Angst vor dem Hype, dass es an Schwung verliert, dass eine andere Lösung mit besserer Performance/Reinheit auftaucht, und dass wir in 1-2 Jahren alles von vorne schreiben müssen, weil niemand mehr TypeScript verwendet ^^
- es schafft eine Hürde für Entwickler, die dem Projekt beitreten wollen. Es ist nicht nur JS, sondern eine ganz andere Sprache, die man beherrschen muss.
Sagt mir eure Meinung dazu, das interessiert mich
Kleines Update zu meinen verschiedenen Erkundungen zu den verschiedenen ORMs
Knex: Es ist cool, aber tatsächlich ist es ziemlich minimalistisch, es macht nur Query-Building
Knex + Bookshelf: Die Macht von Knex, aber mit einem ORM zur Modellvalidierung. Danach ist die Namensgebung der Funktionen und der Flow ein bisschen seltsam und nicht so modern (es riecht nach einer alten Bibliothek, die sich nach und nach modernisiert hat, nicht alles ist immer logisch). Das Bookshelf-Projekt scheint gewartet zu werden, aber nicht mit einer nachhaltigen Entwicklung.
Um ein Modell zu erstellen:
 const User = bookshelf.Model.extend({
    tableName: 'users'
  });
Zum Einfügen:
const newUser = await User.forge({name: 'Tony'}).save();
console.log(newUser.toJSON());
Ich bin kein Fan der Namensgebung und des Flows. Warum forge? Warum .save()? Warum toJSON()?
Ich finde es ein bisschen schwerfällig.
Anzahl der Downloads: 33k/Woche.
Sequelize: Ich hatte Vorurteile gegenüber Sequelize, und ich habe es getestet, und tatsächlich ist es der Hammer  . Der Migrationsbereich ist sehr gut verwaltet, und es ist viel weniger eine Gasfabrik, als ich dachte.
Du definierst deine Modelle so:
const Contact = sequelize.define('Contact', {
    id: {
      type: DataTypes.UUID,
      primaryKey: true,
      defaultValue: DataTypes.UUIDV4,
    },
    firstName: DataTypes.STRING,
    lastName: DataTypes.STRING,
    phone: DataTypes.STRING,
    email: DataTypes.STRING
  }, {});
Und dann ist es super einfach:
const newContact = await db.Contact.create({
    firstName: 'Scooby',
    lastName: 'Doo',
    phone: '444-555-6666',
    email: 'scooby.doo@misterymachine.com'
  });
Sie haben außerdem ein CLI, das der Hammer ist und das Ausführen von Migrations/Rollbacks ermöglicht, es ist super gut gemacht.
node_modules/.bin/sequelize db:migrate:undo
node_modules/.bin/sequelize db:migrate
In Bezug auf Wartung und Anzahl der Downloads sind wir bei 283k Downloads/Woche, also ist es ziemlich beliebt.
Und am Ende ist es sehr weit von Sails entfernt in Bezug auf „Locking“, man kann eigentlich tun, was man will. Es ist wirklich frei.
Letztlich ist es nach dem Test mein großer Favorit Man muss testen, um sich eine Meinung zu bilden!
Ja und +1 für die Indexverwaltung 
Persönlich habe ich Sequelize für ein Projekt verwendet. Und wirklich, es ist super. Schon in Sachen Sicherheit ist es praktisch, weil man tatsächlich präzise Modelle definieren kann (isEmail, number, regex, …).
Und in der Anwendung ist es einfach super einfach!! Bedingungen leicht anwendbar, Modifikationen, Nutzung, alles ist top. Wenn man await/async verwendet, wird es übermächtig
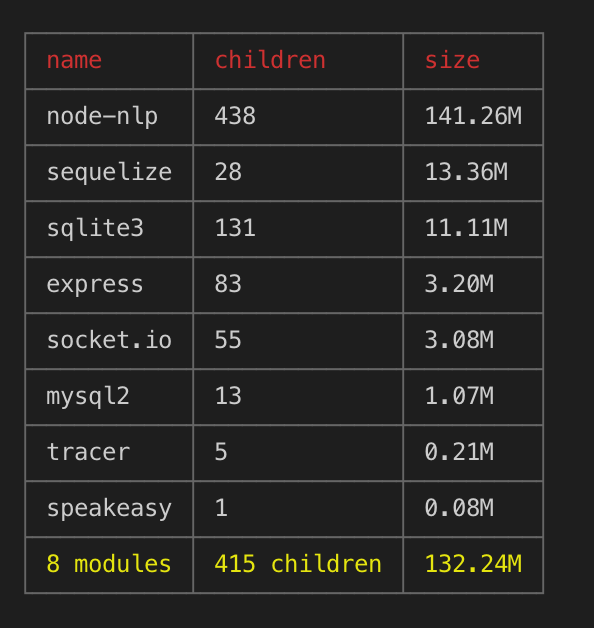
Bei der Untersuchung enthält nur ihr Modul:
- Die Dokumentation
- Screenshots
- Unnötige Dist-Dateien
Wenn man das alles löscht, reduziert sich die Bibliothek von 60 MB auf 9 MB!
Ich denke, ich werde ihnen einen PR machen
Hop PR geschoben =>
Ich habe mit einem „playground“-Repo für Gladys 4 begonnen, das wahrscheinlich bis zum Merge in den Haupt-Repo im Entwicklungs-Repo bleibt.
https://github.com/GladysAssistant/gladys-4-playground
Ich habe heute Morgen die nervige Arbeit erledigt, nämlich eine hyperstrikte und solide ESlint-Konfiguration zu erstellen.
Um sicherzustellen, dass es superstrikt, aber realistisch ist, habe ich das an der Konfiguration des Gladys Gateways ausprobiert. Ich habe die Grundkonfiguration von Airbnb erweitert und meine eigenen Regeln hinzugefügt.
Beim Gateway hat es 2.500 Fehler gefunden (obwohl ich bereits eine eher strikte Konfiguration hatte), ich bin mit dem Ergebnis eher zufrieden
Ich habe das in den playground-Repo gepusht
Hallo zusammen!
Also ich habe heute nicht gerade gefaulenzt, ich habe das gesamte „backend“-Projekt erstellt Es ist ein erster POC, nichts Endgültiges. Das Ziel ist zu sehen, ob uns die Ordnerstruktur/der Code gefällt. Auch der Codestil.
Alles ist hier verfügbar =>
https://github.com/GladysAssistant/gladys-4-playground/tree/master/server
Ich habe ESlint im hyper-strikten Modus aktiviert, wie ich oben schon sagte.
Ich habe APIDoc + JSDoc + ein ESlint-Plugin aktiviert, das die Kommentare validiert und Code ohne Kommentare ablehnt, und das überprüft, ob der Code und die Kommentare synchron sind (und das ist magisch!)
Demonstration:
Sagt mir, was ihr davon haltet.
Ich bin noch nicht begeistert von allem, um ehrlich zu sein, ich habe das Gefühl, dass das Projekt im Moment ein bisschen „unfertig“ ist…
Es muss für jeden verständlich sein, der das Projekt betritt!
Ich habe gerade die Tests + die Abdeckung auf TravisCI eingerichtet: