Hallo zusammen!
Für diejenigen, die diesem Thema nicht gefolgt sind, arbeite ich seit Ende Juni an einem großen Update für Gladys.
Dieses Update wird die Art und Weise ändern, wie der Speicher der historischen Sensorwerte in Gladys funktioniert, indem es von einem Speicher in einer OLTP-Datenbank (SQLite) zu einer OLAP-Datenbank (DuckDB) wechselt.
Wir behalten SQLite für alle relationalen Daten (Benutzer, Haus, Szenen, usw.), es sind nur die Sensorwerte, die in DuckDB gespeichert werden.
Konkreter gesagt, wird dieses Update allen Benutzern Folgendes bieten:
- Viel kleinere Datenbanken. @GBoulvin ist von einer Datenbank von 11 GB auf 65 MB mit DuckDB übergegangen, für 11 Millionen gespeicherte Zustände. Dies ist möglich, weil diese beiden Datenbanksysteme überhaupt nicht auf die gleiche Weise funktionieren und DuckDB Time-Series-Daten aggressiv komprimiert.
- Präzise und ultra-schnelle Grafiken, selbst über lange Zeiträume. Schluss mit den ungenauen aggregierten Daten von Gladys, es ist jetzt möglich, Grafiken über lange Zeiträume zu erstellen, die alte Daten und Live-Werte eines Sensors mischen, was bisher nicht möglich war!
- Eine bessere allgemeine Performance von Gladys: Schluss mit den Datenaggregationsprozessen alle Stunden, die die Festplattenbandbreite auf kleinen Maschinen belegt haben.
Warum hat man bis jetzt auf dieses revolutionäre System gewartet?
DuckDB ist die einzige Datei-OLAP-Datenbank auf dem Markt.
Bisher war DuckDB in der Alpha/Beta-Phase, und jede Version brachte noch immer breaking changes mit sich, was nicht mit unserem Stabilitätsbedarf in Gladys kompatibel war.
Im Juni 2024 wurde DuckDB 1.0 (stabil) veröffentlicht, und ich habe sofort mit den Arbeiten begonnen, um auf dieses System umzustellen.
Was als Nächstes kommt
Ich habe diese Version bereits seit Anfang der Woche auf meiner Instanz zu Hause installiert, um sicherzustellen, dass alles in Ordnung ist, und bisher läuft alles perfekt.
Wenn alles so weitergeht, werde ich diese Version am Montag, den 26. August veröffentlichen 
Sofort migrieren?
Wenn du dich mit der Kommandozeile auskennst und auch sofort auf diese Version migrieren möchtest, kannst du das tun! (Und mir Feedback geben).
Das Docker-Image ist unter folgender Adresse verfügbar:
gladysassistant/gladys:duckdb
Du kannst diese Version pullen:
docker pull gladysassistant/gladys:duckdb
Dann deinen bestehenden Gladys-Container stoppen:
docker stop gladys && docker rm gladys
Dann einen Gladys-Container mit dem DuckDB-Image neu starten:
docker run -d \
--log-driver json-file \
--log-opt max-size=10m \
--cgroupns=host \
--restart=always \
--privileged \
--network=host \
--name gladys \
-e NODE_ENV=production \
-e SERVER_PORT=80 \
-e TZ=Europe/Paris \
-e SQLITE_FILE_PATH=/var/lib/gladysassistant/gladys-production.db \
-v /var/run/docker.sock:/var/run/docker.sock \
-v /var/lib/gladysassistant:/var/lib/gladysassistant \
-v /dev:/dev \
-v /run/udev:/run/udev:ro \
gladysassistant/gladys:duckdb
(Vergiß nicht, diesen Befehl für deinen persönlichen Fall anzupassen)
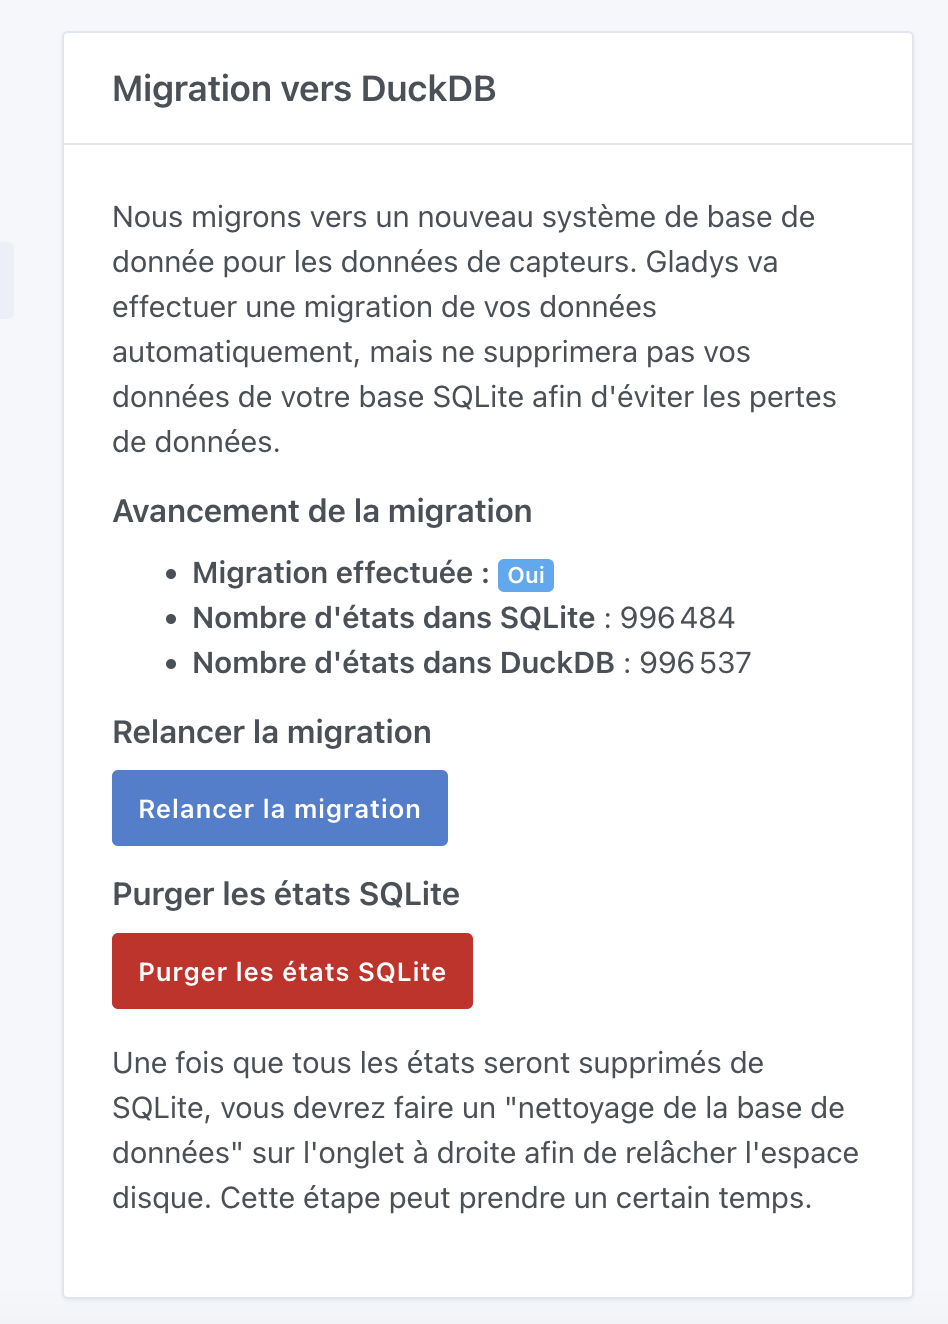
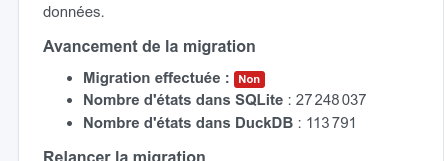
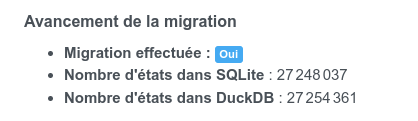
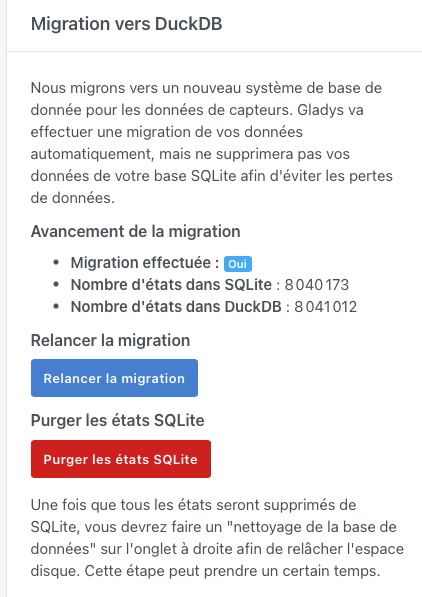
Danach kannst du den Migrationsstatus auf deinem Dashboard sehen.
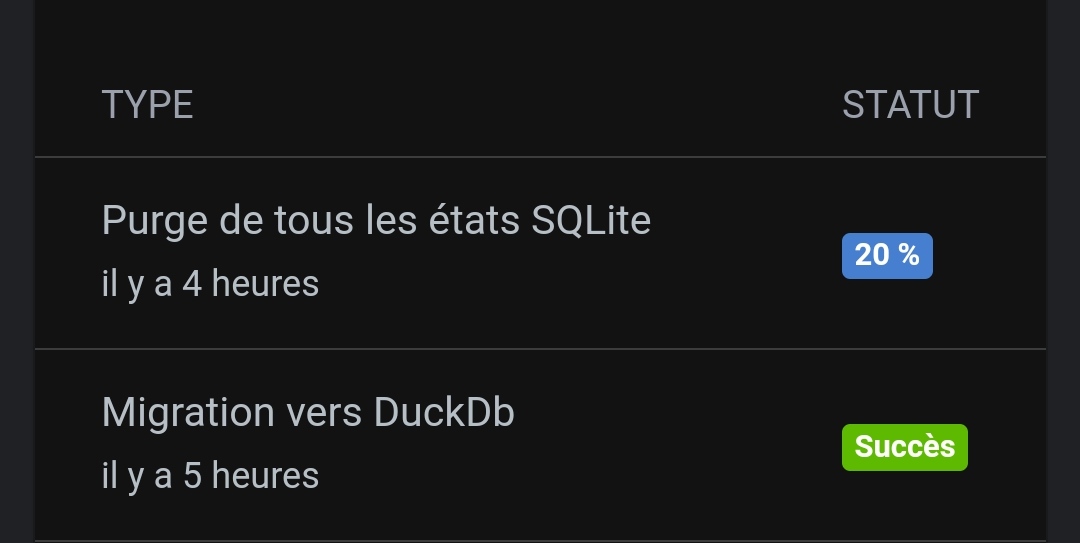
Und sobald die Migration abgeschlossen ist, kannst du die alten SQLite-Zustände in den Einstellungen → « System » von Gladys löschen:
Hinweis: Natürlich musst du nach dem Update wieder zum Image gladysassistant/gladys:v4 zurückkehren!
Wenn du ein wenig warten möchtest
Wenn du am 26. August nicht zu Hause bist und vermeiden möchtest, dass das Update automatisch durchgeführt wird, wenn du nicht da bist, kannst du Watchtower bis dahin pausieren und Watchtower bei deiner Rückkehr neu starten, was dir mögliche Probleme erspart, die du nicht remote beheben könntest.
Ich setze SQLite und DuckDB nicht gegeneinander
SQLite ist ein fantastisches Werkzeug, das wir weiterhin in Gladys verwenden.
Allerdings ist für einen bestimmten Anwendungsfall, den wir haben (Speicherung von Time-Series-Daten), DuckDB viel besser geeignet.
Für den Rest der Tabellen bleibt SQLite die beste Lösung auf dem Markt für unsere Nutzung, und ich bleibe ein überzeugter SQLite-Nutzer!
Ich setze diese beiden Datenbanken also überhaupt nicht gegeneinander, es sind zwei radikal unterschiedliche Produkte 
Vielen Dank an diejenigen, die testen werden, ich habe wirklich große Vorfreude darauf, diese neue Technologie in euren Händen zu sehen!










 Man musste lokal gehen und nicht auf Gladys Plus:






 Wechsle sofort wieder zum DuckDB-Image!!