Hinzufügen einer APIRest-Anfrage an Gladys, um die Zustände der Features in einem Bereich abzurufen

Funktionsbeschreibung
Das Ziel dieser Funktion wäre es, eine lokale Gladys-APIRest-Anfrage zu haben, mit der alle Zustände der Gerätefunktionen mit einem Zeitbereich von Datum/Uhrzeit zu Datum/Uhrzeit abgerufen werden können.

Die gewünschte Nutzung wäre beispielsweise, um die verbrauchte oder erzeugte Energie in 1 Stunde abrufen zu können, um Berechnungen über Node Red durchzuführen. Denn aktuell kann Gladys keine Berechnungen durchführen, und Node Red enthält keine Datenbank (warum überhaupt die Daten zweimal speichern), aber dort können Berechnungen durchgeführt werden.

Verlinkung zum folgenden Thema:

Bon, ja, es ist tatsächlich schnell @pierre-gilles ^^

Es funktioniert über den Zeitintervall, ich habe also genau deine Methoden für die Aggregation übernommen ^^ aber nur die „live“-Daten belassen

Also nur zwei kleine Fragen:

  • ob du mir schnell den Befehl für die Datenbank zum Sortieren von Startdatum bis Enddatum und das zu verwendende Format in den Abfragen sagen kannst (z. B. start_interval = « 01032022 12:00 » & end_interval = « 3103202 12:00:00 »), wenn es dir zu viel Zeit in Anspruch nimmt, kein Problem, ich werde suchen.
  • ich habe auch das „multi“ übernommen, ich sehe, dass du die „,“-Zeichen aufteilst, ich habe also angenommen, dass du mehrere device_feature_selector senden kannst, die durch „,“-Zeichen getrennt sind. Aber beim Testen mit Insomnia gibt es „Not found“, mache ich etwas falsch?^^

Okay, es ist gut gegangen!!^^ Einfach, wenn man am richtigen Ort sucht ^^ op.lte!!
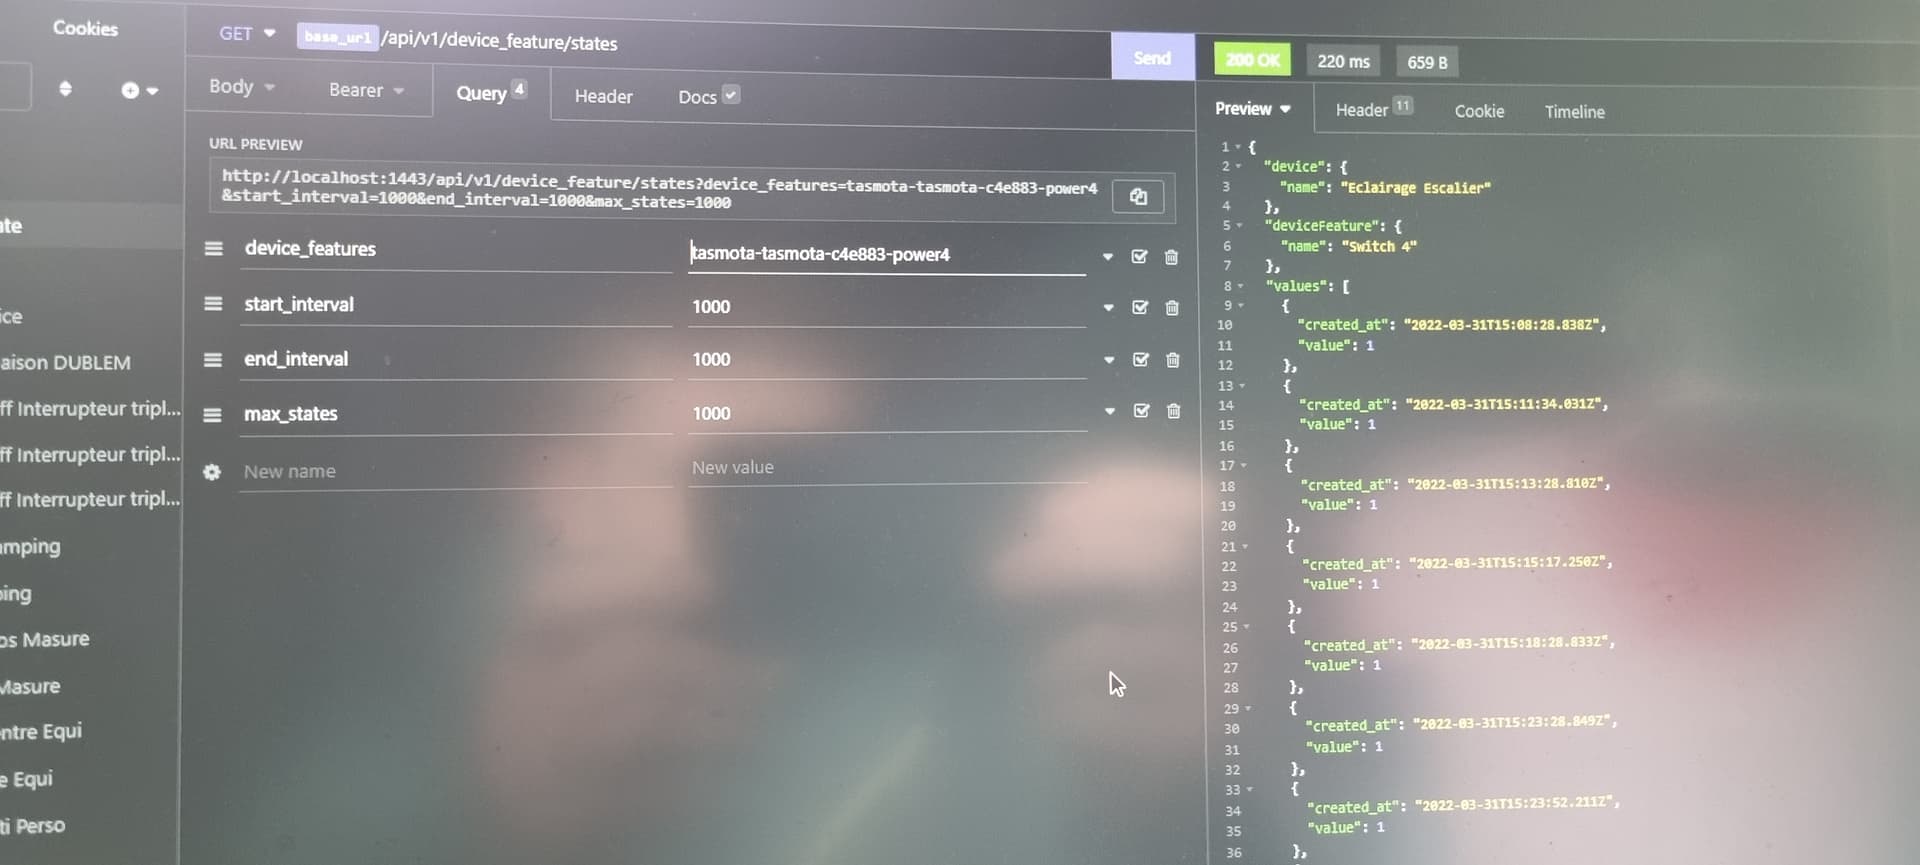
Für das Datumsformat mache ich: "2022-03-01T10:00:00.000Z, sag mir Bescheid, wenn du willst, dass wir es besser machen ^^ aber es funktioniert gut:

Ich werde den PR erstellen.

Edit: Es ist hier erledigt https://github.com/GladysAssistant/Gladys/pull/1496

Ich hatte nicht verstanden, dass du trotzdem ein „Live“-Downsampling machen willst (das könnte CPU-mäßig schwer werden, besonders im Hauptthread), warum gibst du nicht einfach die „rohen“ Daten in dieser Route zurück? Ich dachte, es ginge um einen Export? Willst du nicht die Vollständigkeit?

Das Maximum, was wir tun können, ist, einen „take“ und einen „skip“ für die Paginierung zu setzen, aber trotzdem alle Daten zurückgeben, oder?

Haha !!
Also, um ganz ehrlich zu sein, mache ich nur selten Datenbank-Rückgewinnung und bin eher Autodidakt. Ich habe eine halbjährige Schulung bei der Arbeit, weil ich damit immer mehr zu tun haben werde.

Also hast du wahrscheinlich recht mit dem, was du mir sagst, aber ich muss dich bitten, mir mehr darüber zu erzählen, was du mit der Rückgewinnung der Rohdaten statt des JSON meinst. (Nur die Werte von Datum zu Datum ohne die created_at-Daten abrufen?)
Was bringt die Paginierung dann??^^
Entschuldige für meine Unwissenheit, ich verstehe die CPU-Auswirkungen bei solchen Abfragen wirklich noch nicht.

Und ja, das Ziel ist es, alle Zustände zwischen zwei Daten abzurufen.

Vielen Dank im Voraus für deine Präzisionen.

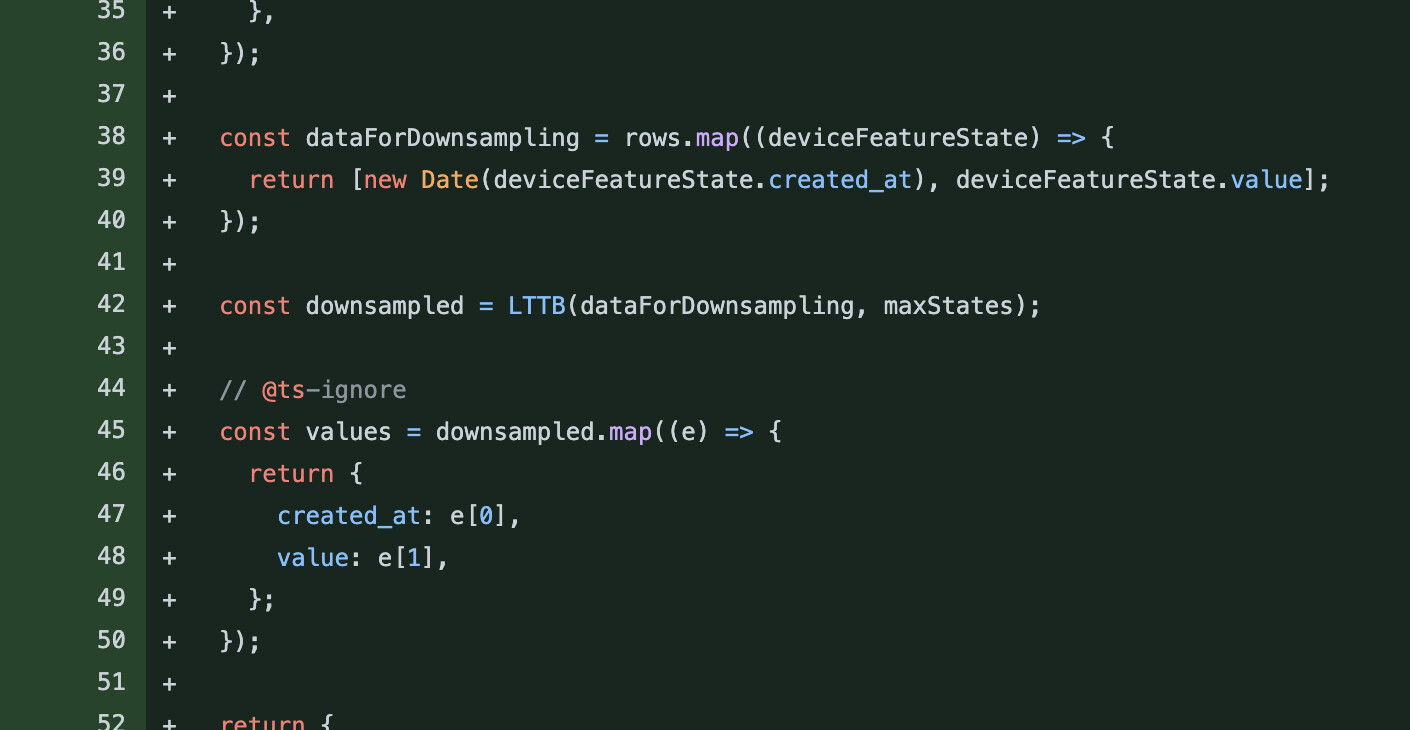
In deinem PR machst du Downsampling:

Als ich „roh“ sagte, meinte ich, dass du kein Downsampling machen und einfach die Rohdaten aus der DB zurückgeben sollst. Ich denke, das ist das, was du tun willst, oder?

Ja, ich denke, das wird ausreichen. Ich probiere es mal so aus.

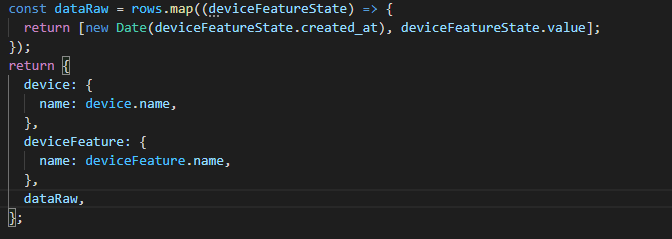
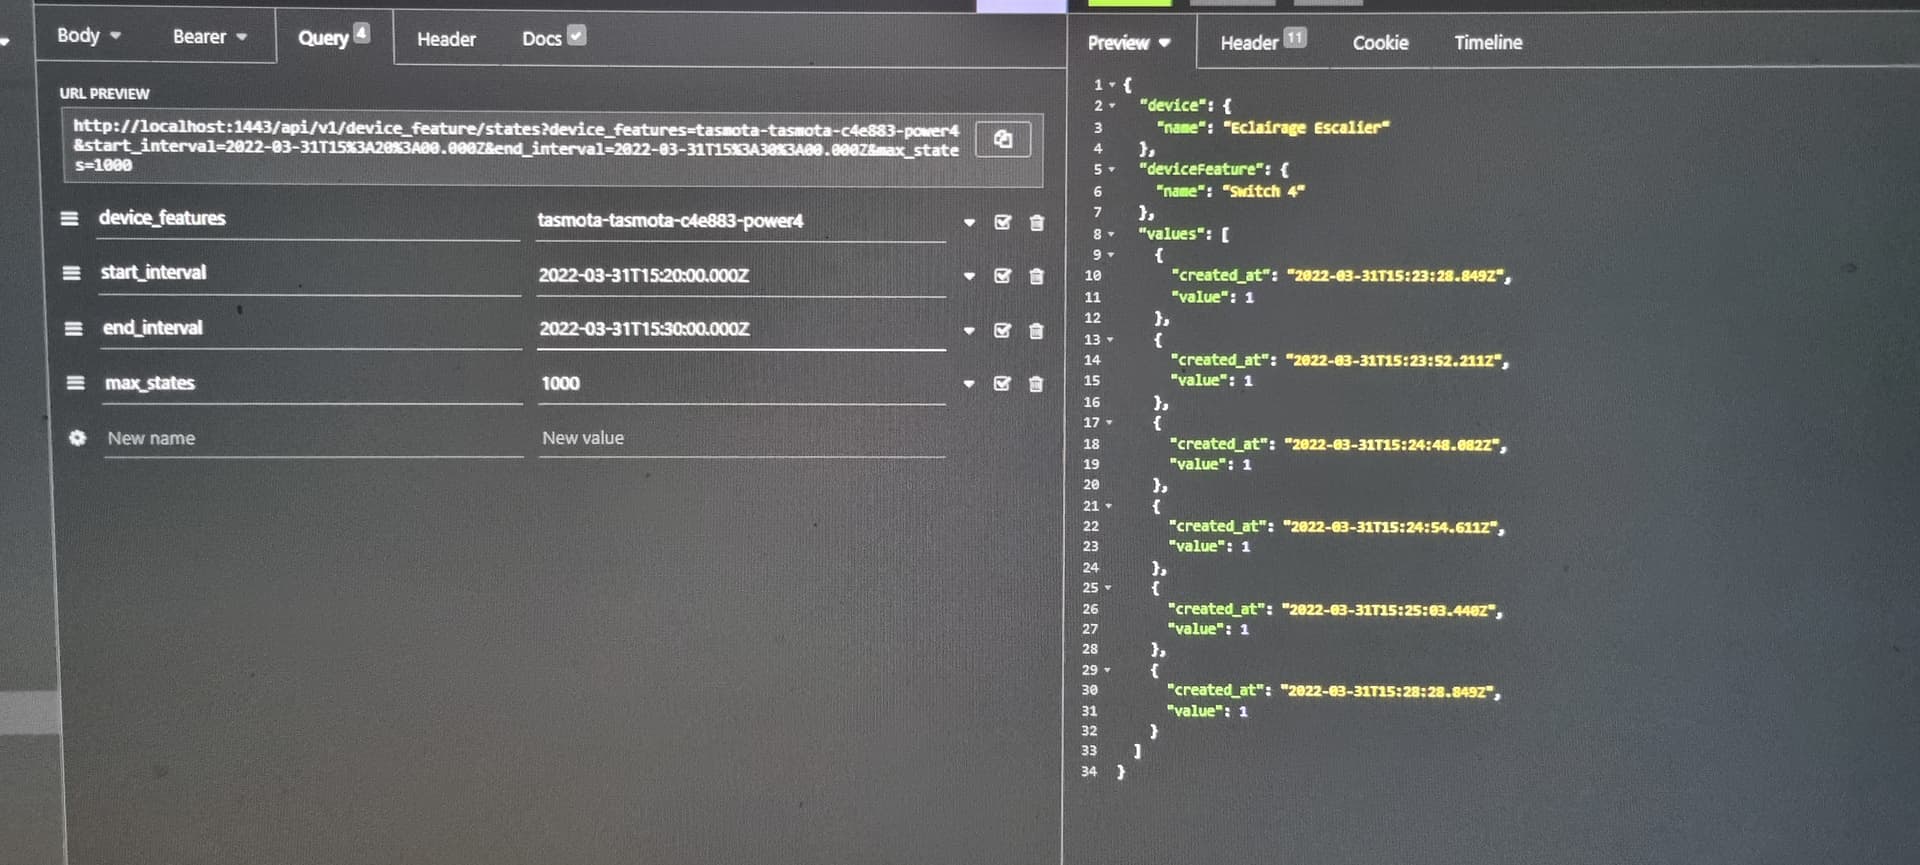
Wenn ich so gehe, ist es besser? :


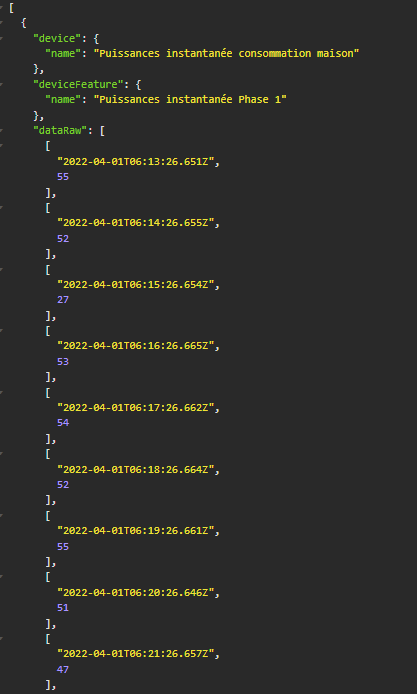
Ergebnis:

Und dann entferne ich den maxState. Nicht nötig bei dieser Art von Anfrage.

Edit: Der PR ist aktuell!!

@pierre-gilles,

Ich habe in der PR gefragt, ob ich die REST-API-Dokumentation ändern soll oder ob du dich darum kümmerst? Ich habe nicht herausgefunden, wie man diese ändert, und in der PR steht:
image
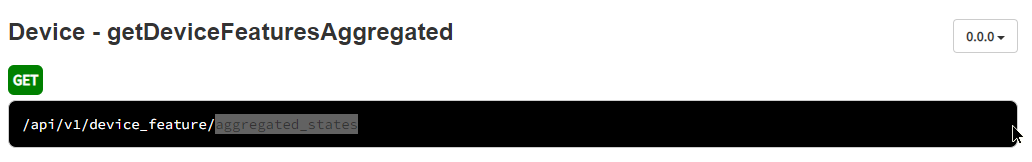
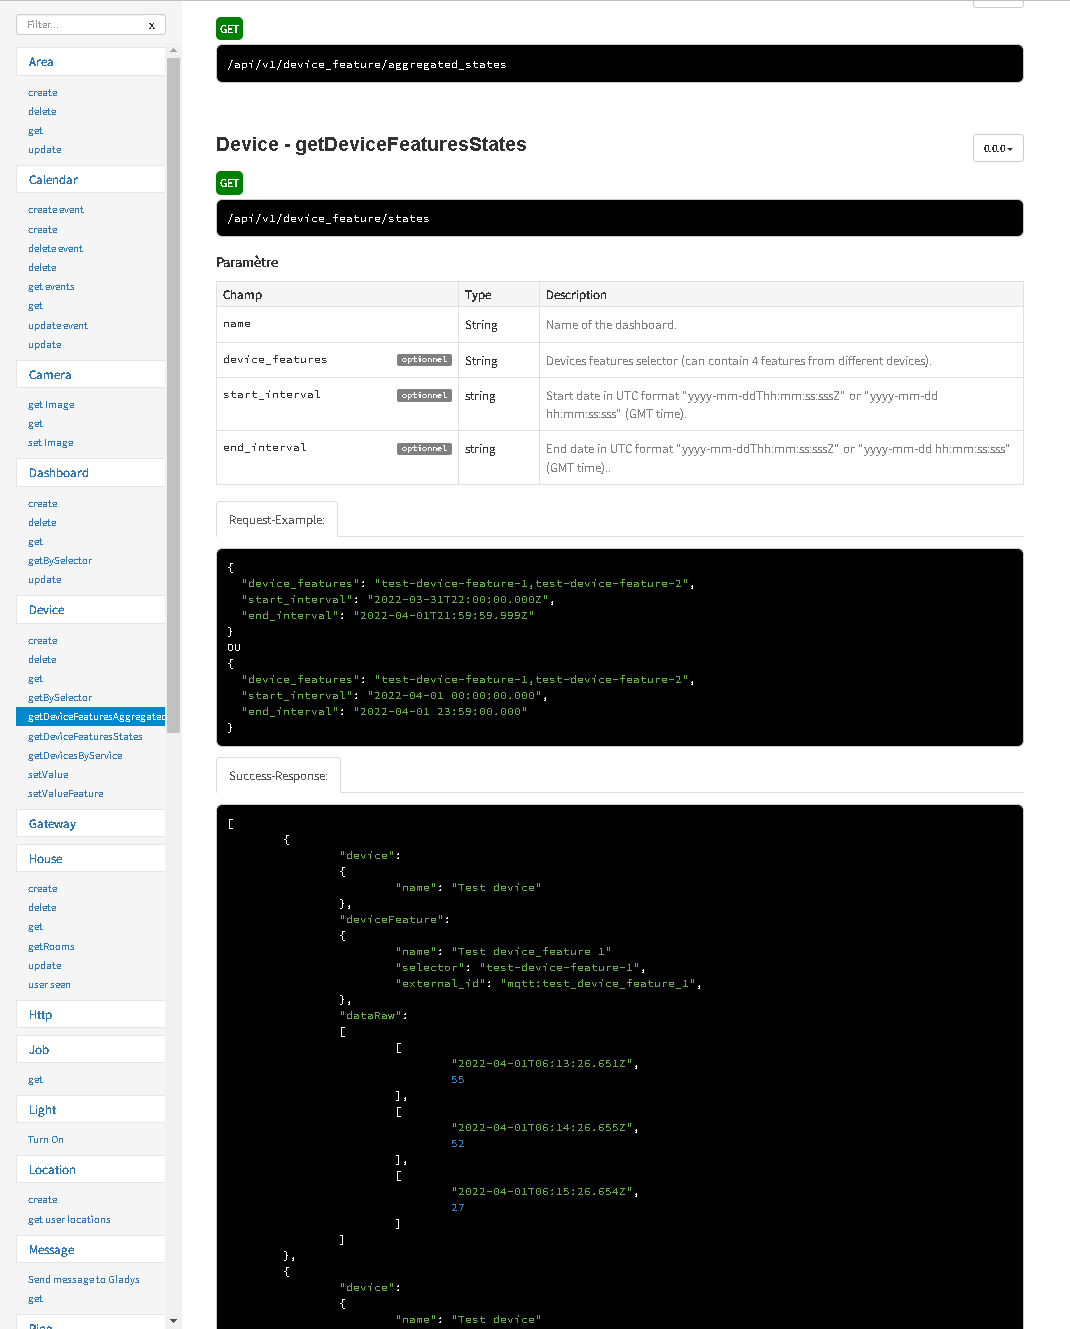
Aber wenn ich in der Gladys REST API-Dokumentation nachsehe, enthält der Abschnitt „Device - getDeviceFeaturesAggregated“ nicht die Beispiele und Abfragen, die in der Datei erwähnt werden:

Das scheint also nicht automatisch zu sein, oder?

Edit:
Okay, ich rede zu schnell, ich glaube, ich habe es mit dem Dashboard-Beispiel gefunden ^^ Gibt es eine Möglichkeit, das zu visualisieren?

Das ist deine Aufgabe, die Dokumentation zu ändern :slight_smile:

Um deine Änderungen zu testen, gehst du in den Ordner server und führst aus:

npm run generate-apidoc

Dadurch wird ein Ordner apidoc generiert.

Darin öffnest du den Ordner und öffnest die Datei index.html in deinem Browser, dann hast du die generierte Dokumentation :slight_smile:

Okay super danke.

Normalerweise muss man nur noch überprüfen und dann ist es gut ^^ den generierten Ordner lasse ich, wenn ich git push oder muss ich ihn vorher löschen?

Er ist in der .gitignore-Datei, also wird er nicht hochgeladen :slight_smile:

Top, danke vielmals.

Okay, ich habe gerade die letzten Änderungen gepusht, von meiner Seite sieht die Dokumentation gut aus,

Wenn es für dich okay ist, kannst du es übernehmen ^^

Edit :
Mein Fehler, ich hatte die « optional » Felder in den Einstellungen nicht gesehen, ich entferne sie und pushe sie in 2 Minuten erneut

Edit2 : Es ist gut ^^

Danke für dein PR!

Ich habe ein paar Rückmeldungen, ich gebe dir heute noch Feedback!

Eigentlich habe ich mehrere Fragen zu dem, was entwickelt wurde.

So wie es jetzt ist, hast du einfach die Funktionsweise kopiert, die auf der Route « aggregated_states » verwendet wurde. Diese Route hatte einen bestimmten Zweck: die Anzeige von Sensorwertdiagrammen für mehrere Sensoren zu ermöglichen.

Die Parameter und das Format dieser Route sind spezifisch für diesen Bedarf, und ich bin mir nicht sicher, ob es hier der gleiche Bedarf ist. Daher denke ich nicht, dass das gleiche API-Format beibehalten werden sollte.

Ich frage mich, ob der Bedarf hier nicht eher eine Route in diesem Stil ist (zu diskutieren):

GET /api/v1/device_feature/:device_feature_selector/state

Mit den GET-Parametern:

?from=DATE
&to=DATE 

(Ich habe start_interval / end_interval geändert, weil wir bereits dieses from/to in einer anderen Route hatten, /api/v1/user/:user_selector/location)

Dies würde möglicherweise die Möglichkeit bieten, optionale Parameter hinzuzufügen: ?take= und &skip für diejenigen, die diese Route verwenden möchten, um große Datenmengen in Chunks zu exportieren, um diese Daten beispielsweise in ein Grafana zu injizieren, ohne die Leistung ihrer Instanz zu beeinträchtigen ^^

Die Antwort dieser Route wäre ein Array von States in ihrem DB-Format:

[
  {
    "id": "4ad21395-686b-41e5-988c-6e9201ba985a",
    "value": 10,
    "created_at": "2022-04-04 19:26:16.815 +00:00",
    "updated_at": "2022-04-04 19:26:16.815 +00:00"
  }
]

Ich denke, das ist lesbarer und besser an das angepasst, was wir hier tun wollen. Die Tatsache, dass nur ein einzelnes device_feature in dieser Route angefordert wird, ermöglicht es, die Paginierung zu verwalten, falls erforderlich, für jemanden, der Exporte durchführen möchte, ohne seine Gladys-Instanz zu überlasten (was wahrscheinlich dein Fall ist, nehme ich an!! :D)

Was denkst du darüber?

Ich komme später auf den Code zurück, aber im Moment ist für mich das Wichtigste, sich auf die Spezifikation zu einigen!
Zuerst einmal vielen Dank für dein Feedback.

Ja, das, was du da vorstellst, kann durchaus ein anderer Bedarf sein. Man muss schauen, ob die beiden im selben Format kompatibel sind.

Das Ziel hier war, Berechnungen durchzuführen, der Bedarf ist also völlig unterschiedlich - Beispiel:

  • Ich speichere Energiewerte für jede meiner Phasen und für jeden Teil des Gebäudes alle Stunden über einen Tag, 7 Tage, 1 Monat, 1 Jahr…
  • In Node-Red stelle ich jeden Tag eine Anfrage « from=j-2 » & « to=j-1 », um alle Werte aller Phasen des vorherigen Tages (jedes device_features) abzurufen.
  • Ich hole den Selector jedes device_features, addiere die zugehörige Ausgabe-Tabelle und gebe sie in ein anderes device feature aus (das einen fast identischen Selector hat - « jour » statt « heure »).
  • Dann addiere ich den gesamten Verbrauch jeder Phase, den ich an ein anderes device_feature zurücksende, und schließlich addiere ich alle Phasen für ein globales device_feature des Verbrauchs.
  • Ich mache dasselbe alle 7 Tage, alle 1 Monat, …
  • Ich mache dasselbe für die Produktion der Solarpaneele.
  • In den vorherigen Schritten habe ich darauf geachtet, alles in Node-Red-Variablen mit dem Namen der Selectoren der device_features zu speichern, und ich kann die Differenz zwischen Produktion und Verbrauch in denselben Zeitintervallen berechnen.

Warum also auf einen einzigen device_feature_selector beschränken? Wir sind uns einig, dass es dasselbe ergibt, wenn man nur einen einzigen device_feature_selector in der Option angibt?

Eigentlich macht es mir nichts aus, das von dir vorgeschlagene Ausgabeformat zu verwenden. Ich dachte fälschlicherweise, dass es aufwendiger wäre, 3 / 6 / 9 separate Anfragen zu stellen, als nur eine einzige, wenn ich 3 / 6 / 9 device_features gleichzeitig verarbeiten möchte. Aber wenn es so leichter ist, reicht es für meinen persönlichen Fall, eine Schleife über die Node-Red-Funktion zu machen. Das geht in Ordnung.

Das ist nicht dasselbe, weil man keine Paginierung machen kann, wenn man mehrere Geräte gleichzeitig verwendet

Das hängt von der Größe der API-Antworten ab.

Im Frontend ist die Route aggregated_states eine sehr kleine Route, da die Daten aggregiert werden, und daher haben wir ein JSON, das auch mit 3-4 ausgewählten device_features eine akzeptable Größe hat.

Zum Zweck des Datenexports wird dein API-Aufruf möglicherweise 2000 Zeilen pro Sensor zurückgeben (und 2000 Zeilen sind schon großzügig, manchmal sind es 10-20-30k in deinem Fall).

Wenn du ohne Paginierung gruppierst, erhältst du eine riesige JSON-Payload, und das ist aus mehreren Gründen nicht ideal:

  • Ein JSON.stringify eines riesigen Objekts ist eine blockierende Operation in Node.js, die den CPU blockiert
  • Hoher RAM-Verbrauch bei diesen Anfragen, wenn die Antwort zu groß ist
  • Die Datenbank könnte plötzlich überlastet werden, was zu Blockaden führen kann

Während du nur einen Export durchführen möchtest, ist die Exportgeschwindigkeit nicht wichtig, ist es besser, mehrere Anfragen in angemessener Größe zu stellen als eine einzige riesige Anfrage :slight_smile:

(Achtung, was ich sage, gilt nicht für eine Frontend-Logik hier, ich denke nur an den Fall des Exports)

Ach okay, jetzt verstehe ich besser!!

Danke für deine Antwort, das klärt mir vieles und tatsächlich, auf der anderen Seite (Node Red oder anderes) gibt es nur Vorteile, es ist nur die Informationsverarbeitung, die anders sein wird.

Ich mache die Änderungen in diesem Sinne und komme auf dich zurück, sobald es erledigt ist, nach meinen Tests.

Hallo @pierre-gilles,

Gut, die Änderungen sind gemacht, und tatsächlich ist es viel logischer, es so zu machen. Ich muss meine Kopie überarbeiten, um die Schleifen über alle Gerätemerkmale vom Typ Leistung/Energie zu machen, aber das geht sehr gut.

Also funktioniert alles perfekt, ich habe mir erlaubt, auch eine Option in der req.query für die attributes hinzuzufügen, da ich festgestellt habe, dass ich das Feld « created_at » am Ende nicht brauche, und das ermöglicht es, die Addition direkt am Objekt durchzuführen (zumindest glaube ich das, in jedem Fall erleichtert es mir die Sache. Ich habe eine Standardoption attributes: ['created_at', 'value'] hinzugefügt, um sie nicht verpflichtend zu machen.

Aber noch einmal entschuldige ich mich für meine Unwissenheit, ich habe ohne die Option skip (=0 standardmäßig) und mit einer Option skip = 10 in der Anfrage getestet, und die zurückgegebene Antwort bleibt dieselbe … habe ich etwas übersehen? Wie wird es verwendet? Ich dachte immer, es dient dazu, mehrere Objekte der Länge des skip-Werts zu senden (also wenn 50 Ergebnisse vorhanden sind, gibt es eine Antwort mit 5 Objekten der Länge 10)?

Edit:
Ich lasse meine Frage … zu schnell gestellt!! Entschuldigung, keine Notwendigkeit zu antworten, es reichte, die Dokumentation zu lesen:

skip-Parameter
Verwenden Sie den Abfrageparameter $skip, um die Anzahl der Elemente anzugeben, die am Anfang einer Sammlung übersprungen werden sollen. Zum Beispiel gibt die folgende Abfrage die Ereignisse für den Benutzer zurück, sortiert nach Erstellungsdatum, beginnend mit dem 21. Ereignis der Sammlung:

image

Ich bereinige also den Code, überarbeite die Tests und es sollte gut für die Überprüfung sein (wenn du die Option attributes natürlich bestätigst ^^)

Hallo @pierre-gilles,

Alles klar bei mir, die Tests sind abgeschlossen, du kannst reviewen, wenn du etwas Zeit hast.