Historische Verbesserung der Gerätedaten durch Granularität

Verbesserung der Verwaltung der Geräte-Datenhistorie: Integration einer konfigurierbaren Granularität für die Speicherung von Zuständen

Hallo zusammen,

Ich möchte eine Verbesserung vorschlagen, die darauf abzielt, die Art und Weise zu optimieren, wie Gladys Assistant die von verbundenen Geräten empfangenen Daten verwaltet und speichert. Derzeit wird jeder von einem Gerät für eine bestimmte Funktion übermittelte Zustand in der Datenbank gespeichert, unabhängig davon, ob er sich gegenüber dem vorherigen Zustand geändert hat oder nicht. Diese Methode, obwohl zuverlässig für die Datenspeicherung, kann zu einer schnellen Ansammlung redundanter Daten führen, insbesondere bei Geräten, die in kurzen Intervallen kommunizieren.

Aktuelles Problem: Im aktuellen Kontext führt ein Gerät, das seine Daten alle 30 Sekunden sendet, dazu, dass jeder empfangene Datenwert gespeichert wird, selbst wenn dieser sich nicht verändert hat. Dies kann die Datenbank schnell mit wenig nützlichen Informationen überfluten, insbesondere bei Daten, die eine geringere Granularität erfordern (z. B. Luftfeuchtigkeit oder Batteriestand, die sich kaum ändern).

Vorschlag: Ich schlage vor, eine flexiblere Konfiguration der Granularität der Zustandsaufzeichnung für jede Funktion eines Geräts zu ermöglichen. Dies könnte auf zwei Arten geschehen:

  1. Hinzufügen eines globalen Parameters in den Systemeinstellungen, mit dem eine Zeitspanne definiert werden kann, während der, wenn sich die Daten nicht geändert haben, sie nicht in der Datenbank gespeichert werden. Diese Zeitspanne könnte je nach den Bedürfnissen des Benutzers angepasst oder leer gelassen werden, um das aktuelle Verhalten (systematische Aufzeichnung) beizubehalten. Relativ einfach umzusetzen.
  2. Hinzufügen einer spezifischen Spalte in der Tabelle t_device_feature, um die Aufzeichnungsgranularität pro Funktion zu definieren. Dies würde maximale Flexibilität bieten und es ermöglichen, die Aufzeichnungsfrequenz je nach Art und Nutzen jedes Datenwerts anzupassen.

Vorteile:

  • Signifikante Reduzierung des gespeicherten Datenvolumens, indem nur die wesentlichen Informationen beibehalten werden.
  • Optimierung der Datenbankleistung, indem die Anzahl der Schreibvorgänge begrenzt wird.
  • Erhöhte Anpassungsfähigkeit für den Benutzer, der das Aufzeichnungsverhalten entsprechend den Besonderheiten seiner Smart-Home-Installation anpassen kann.

Beispiel:
Ich habe vor nur 1 Woche einen Thermostat installiert. Ich möchte ihn entfernen:
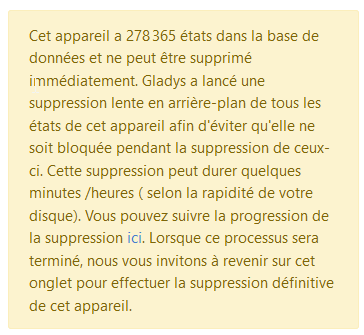

Er hat bereits 280.000 Werte, obwohl er nur alle 2 Minuten pollt. Und die meisten Werte sind identisch. Dies würde die Anzahl der Daten mindestens um das Vierfache reduzieren (etwa 70.000).

@Terdious

Persönlich finde ich, dass beide Lösungen die besten sind, sowohl global als auch die spezifische Spalte!
Es wäre gut, ohne über Zigbee2mqtt zu gehen, die Werte der Sendehäufigkeit der Daten in den Sensoren direkt in Gladys festlegen zu können (mein System ist momentan down, aber ich glaube, dass die Datenübertragung in den Sensoren für bestimmte Sensoren einstellbar ist)

Mist, ich wollte abstimmen, aber ich habe nicht gefunden, wo ich eine Stimme freigeben kann, ich bin am Limit, wenn mich jemand helfen könnte (bin momentan total am Arsch, das nervt mich sooooo! :partying_face:)

Danke @cce66 für dein Feedback zur Frage!

@pierre-gilles, hättest du eine Meinung dazu? Besonders zur Auswahl der vorgeschlagenen Lösungen? Diese? Jene? Beide? Andere? :sweat_smile:

Hallo @Terdious :slight_smile:

Das ist nicht das erste Mal, dass ich dieses Thema höre :sweat_smile:

Meine Meinung hat sich nicht viel geändert, ich finde, dass beide Lösungen das Produkt komplexer machen und keine guten Lösungen sind:

  • Mehrfach das gleiche Wert speichern, das ist trotzdem Information, das ist nicht unnütz.
  • Wenn es wirklich ein Problem mit dem Speicherplatz gibt, dann ist das nur ein Notbehelf für andere Probleme. Besser, man behebt die anderen Probleme.

Ok, das ist eindeutig ein Problem mit der Netatmo-Integration. Man muss die Funktionsweise überarbeiten. Kannst du ein spezifisches Thema erstellen und wir untersuchen diesen speziellen Fall? Ich will alle Daten zu diesem Thema, um zu verstehen, wie ein Gerät in einer Woche 280k Werte erzeugen kann.

Lies dir den Vorschlag noch einmal gut durch. Der Vorschlag erfordert nichts im Vergleich zu heute. Wenn ein Benutzer sich nicht für diese Funktion/Möglichkeit interessiert, muss er nichts anpassen.
Es geht nur darum, dies bei Bedarf/Interesse tun zu können.

Du weißt, dass ich ein großer Nutzer bin. Und ich bin sehr an Daten und Historie interessiert (wir hatten mit @VonOx während und nach einem deiner Lives eine Unterhaltung darüber, wie man die vollständigen Daten visualisieren kann, zum Beispiel mit einem externen Tool wie ElasticSearch).

  • Ich bin überzeugt, dass es sich um unnötige Informationen in der Datenbank für 90% der Funktionen handelt, wenn sich diese Daten nicht ändern. Abgesehen von Webhooks, ist der Zweck des „wilden“ Pollings (30 Sekunden bis 5 Minuten), Änderungen zu erfassen. Und die meisten Geräte funktionieren durch Polling, nicht durch Webhooks.
  • Ich glaube nicht, dass es ein Notbehelf ist, die notwendigen Daten mit etwas mehr Granularität auswählen zu können, die gespeichert werden sollen. In vielen Fällen sind die Daten, die sich nicht ändern, nur zum Zeitpunkt T notwendig, um eine Rückmeldung zu einem Datenrückgabefehler/des Sensors zu erhalten.

Das ist nicht notwendig, es gibt kein Problem, wie ich bereits erwähnt habe, das Polling erfolgt alle 2 Minuten, aber mit Geräten, die 8 Funktionen haben und mit einer Wiederherstellung beim Neustart, kann es vorkommen, dass viele Werte aufgezeichnet werden. Aber das ändert nichts am besprochenen Thema.

Für jemanden, der bereits 100 Geräte mit mindestens 3 Funktionen (es ist oft mehr) und einem durchschnittlichen Polling von 2 Minuten (oft weniger) hat, sind wir bereits bei nicht weniger als 216.000 Zuständen pro Tag. Wenn man, wie ich, die Daten zu jeder Zeit behalten möchte… speichert man eindeutig unnötige Daten. ^^

Aber ja, es wäre interessant, mehr Rückmeldungen von anderen Personen zu diesem Thema zu erhalten!

Wenn sich die Daten nicht ändern, welchen Sinn hat es dann, diese Nicht-Ereignisse zu speichern, solange eine Meldung in einem vom Benutzer definierbaren Intervall erfolgt, dass die Verbindung nicht gestört ist?
Alle Daten zu speichern, kann nützlich sein, falls ein Problem auftritt, ansonsten… es sei denn, die anschließende Aggregation verringert die Größe der Datenbank, indem sie diese unnötigen Daten bereinigt!

Viele Sensoren arbeiten mit Batterien (meist CR2032) und wenn man deren Verschleiß begrenzen kann, ist es sinnvoll, unnötiges Gerede des Sensors zu begrenzen!

Nicht den Wunsch zu haben, eine Art Jeedom- oder HA-Anlage zu bauen, ist klar eine gute Sache, aber an Flexibilität zu verlieren, kann in manchen Fällen stören oder sogar abschrecken, oder?

Hallo,
Das ist zwar nicht das Thema, aber angesichts der Anzahl der generierten Werte denke ich, dass es schade wäre, sie nicht in stündlichen oder täglichen Diagrammen im Verlauf darstellen zu können. Ich nutze daher die Gelegenheit, um die Funktionsanfrage „Wiederherstellung von Diagrammen und ihren Werten über 24 Stunden aus früheren Zeiträumen“ erneut zu stellen.

@Terdious Für mich ist das ein Problem in der Netatmo-Integration.

Tatsächlich, wenn der Poll einen Zustand abruft und ihn alle 2 Minuten speichert, obwohl es keinen echten neuen Zustand gibt, bringt es nichts, ihn an Gladys zu senden. Aber es liegt an der Netatmo-Integration, das zu regeln. Gladys kann nicht den Unterschied zwischen einem « echten Zustand » und einem « duplizierten Zustand » erkennen, während die Netatmo-Integration das kann.

Was gibt die Netatmo-API zurück?

Für mich musst du in den zurückgegebenen Daten nachschauen, ob es eine Möglichkeit gibt, einen Zustand eindeutig zu identifizieren, und dann in deinem Netatmo-Code sollte es so aussehen:

if(lastValueNetatmo > lastValueGladys) {
     this.gladys.event.emit(EVENTS.DEVICE.NEW_STATE, {
         device_feature_external_id: feature.external_id,
         state: readValues[feature.category][feature.type](room.open_window),
     });
}

Edit: Okay, ich habe mir die Netatmo-API angesehen, und da ist es drin!

In jedem API-Aufruf hast du die « last_message », die meiner Meinung nach genau das ist, wonach wir suchen :slight_smile:

Vergleiche einfach das last_message von Netatmo mit dem last_value_changed auf Gladys-Seite, und schon speicherst du nur die neuen Werte.

Das geht in ein paar Codezeilen, ist transparent für den Benutzer und löst genau das Problem, und vor allem ohne die Zustände mit gleichen Werten zu unterschiedlichen Zeiten zu entfernen. 15°C um 9 Uhr != 15°C um 10 Uhr

Was denkst du?

@pierre-gilles, es tut mir leid, aber ich wiederhole, dass dies nicht zum Thema gehört. Meine Frage bezieht sich auf alle Geräte. Unabhängig von der Technologie. Ich habe Geräte, die viel schlechter sind als Netatmo. Und dennoch ist es in einigen Fällen notwendig. Natürlich würde ich es vorziehen, nur bei Wertänderungen und nur eine Daten alle 10 Minuten beispielsweise, um anzuzeigen, dass das Gerät funktioniert. Aber lassen Sie uns eines klarstellen: Kein Gerät macht das. Außer im Fall eines Pollings von Gladys, das dies nur für ein vollständiges Gerät tun würde, nicht funktionsweise. Und in diesem Fall muss man sich für eine Dauer entscheiden, was nichts an den identischen Daten ändert, die vom Benutzer als unnötig angesehen werden könnten.

Apropos Netatmo:
Ja, die Netatmo-API überträgt alle Informationen, die es ermöglichen, alle Fälle sehr gut zu verwalten

Dies löst also kein Problem, denn:

  • Die Ventile liefern alle 2 Minuten einen echten Messwert (daher das 2-Minuten-Polling, das eingerichtet wurde)
  • Die Wetterstationen alle 5 Minuten.

Und genau das ist das Problem:

  • Ja, es ist interessant zu wissen, dass es immer noch 15°C sind, aber vielleicht wäre es für meine Nutzung (ich spreche von jedem Benutzer) « ausreichend » oder angemessener, nur die identischen Werte alle 10 Minuten, oder sogar alle 30 Minuten zu speichern. Dennoch ist es für meine Szenen und für mein Historie wichtig, dass die Änderung alle 2 Minuten sichtbar ist.
  • Aber dann für die Batterie (Daten, die zur gleichen Zeit ankommen) kann es interessant sein zu wissen, ob sie sich alle 2 Minuten geändert hat. Aber wenn sie seit 3 Tagen bei 23% ist, ist es mir völlig egal zu wissen, dass sie in diesen 3 Tagen alle 2 Minuten auf diesem Niveau geblieben ist. Was für mich wichtig ist, ist zu wissen:
    • Dass die Batterie in 3 Tagen nicht rapide gesunken ist (Wertänderung)
    • Dass die Daten in 3 Tagen gut angekommen sind (last_value). Im Zweifel wäre ein Punkt pro Tag bei 23% « nett »

Und in deinem Beispiel, wie du sagst, würdest du es heute nicht zulassen (und ich gebe zu), den Wert ohne Zustimmung des Benutzers zu entfernen, vielleicht sind einige an diesem Wert interessiert.

Aber ja, in der Tat, für die Wetterstation, kann ich das Update nur alle 5 Minuten verschieben.

Aber die Frage bleibt dieselbe für bestimmte Daten, ob alle 2 Minuten, alle 5 Minuten oder alle 1 Stunde.

Rückkehr zum ursprünglichen Thema bezüglich aller Funktionen:


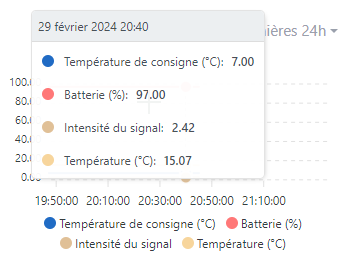
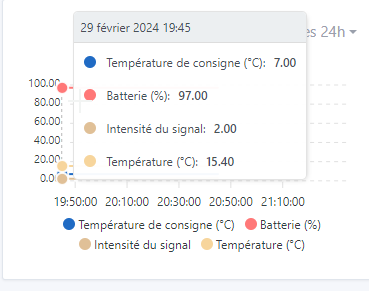
Zum Beispiel hier (Zigbee-Ventil) habe ich zwei Werte, deren genaue Historie mich interessiert, aber für die Batterie zum Beispiel, stören mich die Daten, die sich nicht bewegen.
Und mit dem Vorschlag würde es mich nicht daran hindern zu wissen, dass dieses Gerät immer noch verfügbar ist. Ich wäre glücklich zu wissen, dass es in 5 Tagen auf 96% gesprungen ist. Aber in diesen 5 Tagen hätte ich 1440 unnötige Daten in meiner DB. Es ist fast dasselbe für die Intensität, auch wenn es immer interessant sein kann zu wissen, dass die Signalintensität stark variiert.

Ein weiteres sehr konkretes Beispiel:


Bei Sonoff, Relais/Sensor => Tasmota. Ich brauche eine Verbrauchsverfolgung, insbesondere in unserer Zeit, um den Verbrauch nach einer bestimmten Zeit zu untersuchen, ihn mit meiner Solarproduktion zu vergleichen, etc. Von diesen 5 Daten ändern sich einige nur sehr wenig, einige sind für die Szenen notwendig, einige für die Historie. Dennoch interessiert mich die Mehrheit nicht, um jeden identischen Wert zu speichern. Umso mehr, als wir ein Polling von 1 Minute haben (sehr interessant für Szenen, die insbesondere mit Solarenergie verbunden sind), aber dann kann man sagen, dass 75% der Daten unnötig sind => 5 Funktionen * 60 Minuten * 24 = 7200 Daten pro Tag!! Und solche Geräte habe ich überall in meiner Hausautomation, in meinen Käufen, um meinen Verbrauch zu reduzieren oder zu optimieren, habe ich ein echtes Bedürfnis.

Was ich sagen will, ist, dass die Anwendungen vielfältig sind. Ja, mit einem Bewegungssensor hat man nicht so viele Probleme. Ja, mit einem Licht oder einem Gerät, das nur bei Zustandsänderungen Daten sendet, hat man keine Probleme.

Aber ich bin überzeugt, dass Gladys mit dieser Art von Optimierung einen echten Vorteil gegenüber anderen Produkten hätte. Man kann sogar den ökologischen Aspekt hervorheben (lokale Speicherung / Backups / enorme Entlastung der Datenbankanfragen).

Aber im Moment ist es nur meine Meinung. Ich führe die regelmäßigen DB-Reinigungen fort, um diese Daten in regelmäßigen Abständen zu löschen => Einschränkend.

Um meinen Beitrag zu der Diskussion zu leisten: Ich stimme der Analyse von @Terdious zu, dass es interessant sein kann, in Gladys Daten eines Sensors in sehr regelmäßigen Abständen zu empfangen (um sicherzustellen, dass alles funktioniert und dass ein Wert wirklich nicht geändert wurde (und dass dies nicht auf den Sensor zurückzuführen ist, der keine Informationen mehr sendet)), und gleichzeitig nicht alle Werte in der Datenbank zu speichern, wenn man die Größe auf lange Sicht kontrollieren möchte. Und die Möglichkeit, dies pro Sensor einzustellen, da die Frequenzen je nach Sensortyp und Verwendungszweck variieren werden…

Allerdings sind wir hier eindeutig bei einer erweiterten Einstellung mit Optionen, die die Oberfläche für den „Standard“-Benutzer überladen könnten. Daher könnte dies ein Parameter von Gladys sein, der bewusst von einem erfahrenen Benutzer aktiviert wird und die Sensor-Konfigurationsschnittstelle nur für ihn komplexer macht, wenn er dies wählt.

Genau, ich bestehe wirklich darauf, dass ich mir dessen bewusst bin und das Ziel keineswegs ist, die Dinge zu komplizieren. Ein Option in den globalen Einstellungen, um zunächst auf diese Art von Parameter Feature für Feature zugreifen zu können.
Und dieser Parameter wird sogar von mehr als 50% der Benutzer nicht gesehen, ohne wirklich Auswirkungen zu haben, bewusst, dass eine Hausautomatisierung in einer Wohnung nicht die gleichen Bedürfnisse hat wie in einem Haus mit Grundstück.
Dennoch kann diese Option vollständig in der Dokumentation erklärt werden, aber vor allem kann sie im Forum vorgestellt werden, wenn eine Frage zum Thema gestellt wird.
Ich denke, es ist auch die Art von Option, die für „Werbung“ hervorgehoben werden kann. Ja, Gladys ist benutzerfreundlich und sorgt für die Sicherheit der persönlichen Daten, aber auch die Frage der Leichtigkeit der Datenspeicherung, während gleichzeitig eine maximale Sichtbarkeit auf den kontinuierlichen Verbrauch beibehalten wird.

Ich wäre neugierig, deine Quellen für die Aktualisierungsfrequenz der Daten bei Netatmo zu sehen!

Aus dem, was ich auf anderen Foren lese, ist es alle 10 Minuten:


(Quelle: https://community.home-assistant.io/t/netatmo-weather-configure-update-frequency-or-get-max-values/209628)

Sie sprechen auch von „terms of service“, also müsste man überprüfen, ob die „alle 2 Minuten“, die in der aktuellen Gladys-Integration stehen, nicht gegen die AGBs von Netatmo verstoßen.

Zum ursprünglichen Thema zurück: Für mich ist das eindeutig ein Thema, das mit den Integrationen zusammenhängt, die Polling durchführen.

Ich verstehe das Problem der Netatmo-Integration, bin aber nicht vollständig mit der Lösung einverstanden.

@Terdious vielleicht würde ein kurzes Telefonat mir helfen, besser zu erklären, was mich an deiner Lösung stört? Verfügbar am späten Vormittag von 10:45 bis 11:00 Uhr, wenn du möchtest. Oder sonst asynchron hier, aber ich habe das Gefühl, dass die Diskussion feststeckt und zu viel Zeit in Anspruch nimmt.

Hallo @pierre-gilles,

Danke für deine Antwort!
Und ich habe das Glück, einen großen Teil der Geräte zu haben und vor allem die Möglichkeit, selbst Hand anzulegen ^^
Daher sind meine Quellen einfach meine Daten. (Ich hatte die Geschichte mit den 2 Minuten vor zwei Jahren gefunden, aber ich finde sie tatsächlich nicht mehr - ich habe den Eindruck, dass Netatmo nicht mehr darüber kommuniziert - was mich dazu veranlasst hat, die Tests zu diesem Zeitpunkt durchzuführen)

Schau dir die Daten deiner Artikel an (2020 / 2022), ich habe sie tatsächlich konsultiert!! Es geht hauptsächlich um die Wetterstation (von der ich dir die 5 Minuten weiter oben mitgeteilt habe), und sie sprachen bereits damals von einer möglichen Entwicklung, um von 10 auf 5 Minuten zu wechseln.

Konkrete Beispiele:

  • Energie - RF-Signalqualität Thermostat
    image


    Man kann einen unterschiedlichen Wert alle 2 Minuten feststellen

  • Innen-Wetterstation - CO2 (kann sich stark ändern, 10 Minuten in deinen Quellen - normalerweise 5 Minuten):
    image


    Änderung von 866 auf 842, dann vergehen 4 Minuten und 10 Sekunden und es geht auf 823 über (also genau 5 Minuten, da die Datenänderung zwischen den 44 Sekunden, die für den Übergang von 866 auf 842 vergangen sind, stattgefunden haben könnte => Wir haben 3 verschiedene Daten in 4 Minuten und 51 Sekunden …

  • Wetterstation - Anemometer RF-Signalqualität (die Entfernung lässt sie schwanken):
    image


    Man kann feststellen, dass sich der Wert in 7 Minuten auf 5 Werte (8 hier aufgezeichnete Werte) verändert hat. In diesem Zeitraum habe ich mehrmals neu gestartet. In diesem Fall liegen wir deutlich unter den 5 Minuten (ich kann es nicht erklären, aber die Daten zeigen es)

Es tut mir leid, aber ich bestehe darauf, dass es kein Problem mit der Netatmo-Integration im Besonderen gibt. Das « Problem » (Achtung, ich verwechsle nicht, es ist kein Bug in meinem Kopf ^^) ist in vielen Fällen real (unten zigbee / sonoff)

Wenn du verfügbar bist, mit großem Vergnügen!

Kleine Nachricht, um unser Gespräch zusammenzufassen, @Terdious :slight_smile: Es war schön, sich anzurufen, um das alles ein bisschen zu klären!

  • Ich denke, es liegt an den Integrationsentwicklern, die richtigen Mechanismen zu implementieren, damit ihre Integration nicht « zu aggressiv » in Bezug auf die Datenmenge ist, die sie an Gladys senden.

Im Fall von Netatmo bin ich dafür, im Code fallweise vorzugehen.

Beispiel: Feature « Batterie »: max 1 Punkt alle 30 Minuten, wenn sich der Wert nicht ändert.

Das Ziel ist, dass wir die besten Grenzen finden, die so präzise wie möglich sind, ohne die Größe der Datenbank oder die Leistung von Gladys zu beeinträchtigen.

Für den Benutzer ist das transparent und funktioniert automatisch, im Sinne der Projektphilosophie.

  • Mittelfristig verfolge ich DuckDB sehr genau, eine Dateidatenbank (wie SQLite), aber für Zeitreihendaten optimiert. Die Idee wäre nicht, das SQLite von Gladys zu ersetzen (das perfekt für den Rest von Gladys geeignet ist), sondern nur unsere Zeitreihendaten in eine dedizierte Datei zu übertragen. Laut meinen Tests ist die Reduzierung der Datenbankgröße bei gleichzeitiger Leistungssteigerung im Vergleich zu dem, was wir derzeit tun, ziemlich phänomenal (siehe: Gestion plus fine de l'historique des états - #18 par pierre-gilles)

Derzeit halte ich mich mit der Entwicklung zurück, da sie noch in der Beta-Phase sind (0.10.0). Mal sehen, ob sie sich selbst als « production-ready » betrachten oder nicht.

Ich habe Angst, meine Datenbank ist 22 GB groß, ich werde mal aufräumen :sweat_smile:

Ich habe die Retention von « unbegrenzt » auf « 6 Monate » geändert und eine Reinigung gestartet.
Meine Datenbank ist 22 GB groß und ich habe festgestellt, dass die .wal-Datei auf 15 GB angewachsen ist und den Reinigungsvorgang zum Absturz gebracht hat, weil der Datenträger voll war.

Könnte der Reinigungsvorgang in Batches durchgeführt werden, mit einem Vacuum dazwischen, um diese Situation zu vermeiden?
Ist das eine Feature-Anfrage oder nicht @pierre-gilles?

Die Reinigungsaufgabe wird bereits im Batch-Modus ausgeführt.

Das VACUUM ist eine sehr, sehr schwere und blockierende Aufgabe, die auf langsamen Festplatten bis zu 10 Stunden dauern kann. Daher ist es nicht realistisch, sie automatisch zu starten… sie muss vom Benutzer angefordert werden.

Für Info, ich habe die DuckDB-Community auf ihrem Discord kontaktiert:

Ich habe keine Antworten von DuckDB erhalten, aber ich habe die Antworten auf meine Fragen in einem Video eines Vortrags gefunden, den DuckDB letzten Monat gehalten hat :slight_smile:

Die Version 1 würde im ersten Halbjahr 2024 erscheinen, also theoretisch bis Juli (sofern es keine Verzögerungen gibt).

Laut dem Vortrag:

Es wird sich auf Stabilität und Robustheit konzentrieren
Wir wollen nur sicherstellen, dass dies eine DuckDB-Version ist, die Sie auf einem Satelliten installieren und zum Venus fliegen können, ohne sich Sorgen machen zu müssen, Ihr DuckDB-Instanz zu patchen

Das ist sehr beruhigend, denn genau das suchen wir für Gladys: eine Software, die so stabil ist, dass sie 10 Jahre lang ohne Korruption und ohne menschliches Eingreifen laufen kann.

Die Abwärtskompatibilität ist für Gladys notwendig (um Updates durchführen zu können), und es ist daher sehr positiv, dass dies eines ihrer Ziele für die Version 1 ist.

Der Vortrag:

Kurz gesagt, all das ist sehr positiv. Für mich ist DuckDB die Zukunft von Gladys, wenn alles, was sie versprechen, bestätigt wird :wink: Ich habe bereits Tests durchgeführt, und es ist wirklich sehr, sehr cool.

Allerdings sollte uns dieses Ziel nicht von den anderen Punkten abhalten, die wir weiter oben in dieser Diskussion identifiziert haben: