Buena idea, justo tenía ganas de tener ese tipo de retroalimentación de audio en caso de acción. ¿Dónde escribes tu código? ¿Tienes un teclado (de qué tipo)?
Aquí está la idea que se me ocurre:
En una RPi dedicada, que controla un altavoz, crear un script que se conectará a la red MQTT como cliente
Este cliente MQTT podrá recibir varios valores (digamos, 1, 2 y 3) para activar las 3 acciones que has listado
Así, en tu escena, Gladys puede hacer leer las frases o los pitidos que hayas programado en tu RPi dedicada.
Es muy simplista así, pero hará el trabajo por el momento.
Entonces, para el código… estaba faroleando porque aún no tengo el equipo, pero creo que compraré algo de esta lista: Zigbee2MQTT
Creo que, pasando por Node-red, debería poder hacer una conexión con gladys.
Te confieso que había pensado en tener una Raspberry Pi conectada a un altavoz. Pero « crear un script que se conectará a MQTT como cliente »… eso supera mis competencias ^^
Voy a intentar investigar un poco para ver qué encuentro, ¡compartiré mis hallazgos aquí!
Si encuentras un teclado Zigbee funcional y asequible, me interesa. Pero por lo que he visto en mis primeras búsquedas, es sorprendentemente difícil de encontrar nuevo.
Lo entiendo, en Python hay librerías, pero aún así hay que saber programar un mínimo. No dudes en compartir tus hallazgos de todos modos
Hola, menciono a @spenceur porque usa Node red y sus Sonos para hacer eso.
No he tenido tiempo de volver a mirarlo.
Quería hacer un tutorial basado en sus explicaciones, pero es bastante complejo porque hay muchas cosas que dominar y aún no he logrado hacerlo.
buenas noches a todos, hice una solicitud de función el 5 de agosto para que Alexa pueda hacerlo a través de Gladys. Solo un voto por el momento, el mío. Por lo tanto, me he vuelto hacia node red y Alexa y ahora puedo hacer que Alexa diga una frase. Solo me queda lograr que se active esta frase en una escena a través de mqtt.
Lo confirmo y hay que saber que la librería ultimate-tts puede usarse con altavoces Bluetooth
En mi caso, tengo un mensaje en mi Sonos que me dice alarma activada, alarma desactivada, las noticias de mis calendarios (salud, cumpleaños, etc.)
Y en el lado de Gladys, uso REST para enviar a Node Red y leer el mensaje deseado
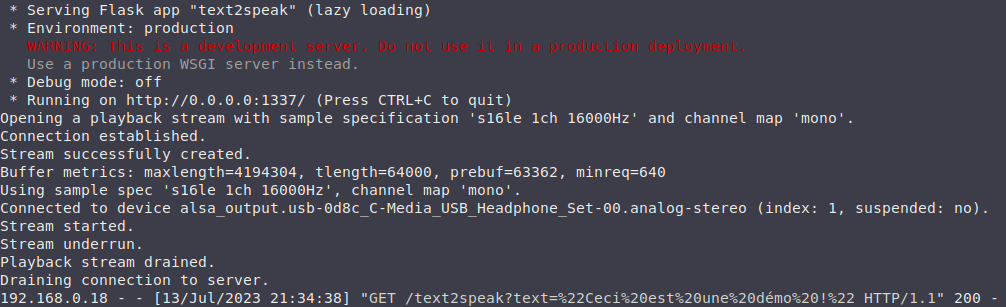
He instalado varios RPi 0W en diferentes habitaciones, conectados a través de dongles USB a altavoces. En cada uno de ellos se ejecuta un servidor Pulse Audio, convirtiéndolos en altavoces conectados por unos 30€ cada uno… Un servidor central tiene un script escrito en Python utilizando Flask para el acceso HTTP, picoTTS para el « texto a voz » y conectado a todos los altavoces (selección de zonas posible si es necesario…). Se llama a este script mediante una solicitud HTTP, y se pasa como parámetro de la solicitud lo que debe decirse a los altavoces. ¡Y listo!
Utilizo este principio para hacer dialogar a Gladys… ¡Es bastante sucio, pero cumple con lo esperado!
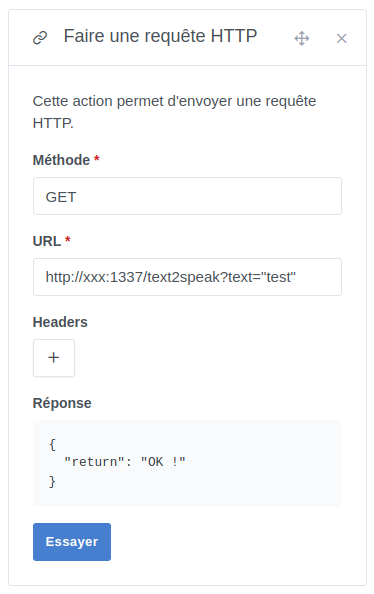
@guim31: No sé muy bien cómo hacer un video sobre el tema, lo siento… En cambio, aquí está el código de Python para empezar, que escucha en el puerto 1337 (lo siento…), y al que se le pasa una solicitud del tipo: http://IP/text2speak?text=« Truc à dire… ». Sin embargo, se necesita disponer de uno o varios servidores Pulse a los que enviar el flujo de audio. También, el script debe disponer de la librería Python « Flask » y del paquete « libttspico-utils ».
#!/usr/bin/env python3
# -*- coding: utf-8 -*-

from flask import Flask, request, jsonify
import os

app = Flask(__name__)

@app.route('/text2speak', methods=['GET'])
def prononce_texte():
	texte = request.args.get('text')
	if texte:
		os.system('pico2wave -l fr-FR -w /tmp/temp.wav {}'.format(texte))
		os.system('paplay -v -s Pulse --volume 32000 /tmp/temp.wav')
		os.remove('/tmp/temp.wav')
		return jsonify({'return':'OK !'})
	else:
		return jsonify({'return':'Missing text to speak ?!'})

if __name__ == '__main__':
    app.run(host='0.0.0.0', port=1337)
Luego, uso un bloque « HTTP » en una escena y llamo al script de Python:
Pregunta relacionada con nuestro intercambio actual: he querido hacerlo un poco más « limpio » pasando por un método POST, pero ¿qué debo colocar en el campo « Body » del bloque HTTP de la escena?