Ich stelle euch eine externe Integration vor, um eure GitHub-Repositories von Gladys aus zu verfolgen.
Was sie macht
Jedes verfolgte Repository wird zu einem Gerät in Gladys, und euer Konto auch. Die Integration orientiert sich an der GitHub-Integration von Home Assistant und fügt Szenenauslöser und Widgets hinzu. Sie nutzt die GitHub-API (cloud) mit einem persönlichen Lesezugriffstoken: Sie kontaktiert nichts anderes und schreibt nie auf GitHub. Sie dient denen, die Code veröffentlichen oder über neue Versionen eines Projekts, das sie nutzen, informiert werden möchten.
Funktionen
Gerät pro Repository: Sterne, Forks, Abonnenten, offene Issues und Pull Requests, fusionierte Pull Requests, Diskussionen, Downloads der letzten Version und als Text die letzte Version, das letzte Tag, Commit, Issue, Pull Request und Diskussion.
Gerät des Kontos: Abonnenten, Abonnements, öffentliche Repositories und Gists.
7 Szenenauslöser: Version veröffentlicht (Filter Version/Preversion), Issue geöffnet, Pull Request geöffnet, Diskussion gestartet, neues Commit, neue Sterne, erfolgreiche oder fehlgeschlagene Überprüfungen (CI).
1 Szenenaktion: Zahlen eines Repositories lesen (für eine Nachricht oder eine Bedingung).
3 Widgets: ein Repository, die letzte Aktivität, das Konto mit dem verbleibenden API-Kontingent.
Einige Beispiele für Szenen:
eine neue Version von Gladys wird veröffentlicht → Telegram-Nachricht mit {{triggerEvent.data.summary}};
die CI meines Projekts schlägt fehl → die Schreibtischlampe wird rot;
mein Repository erhält einen Stern → ein kleines Geräusch auf dem Lautsprecher.
Installation
Über den Store: Sie wird im Laufe des Tages verfügbar sein, sobald die Indexierung abgeschlossen ist.
Oder sofort über die Repository-URL: Integrationen → Integration installieren → https://github.com/William-De71/gladys-github.
Es wird Gladys 5.1.0 oder höher benötigt.
Konfiguration:
erstelle ein Token mit feinkörniger Granularität auf GitHub (Lesezugriff auf „Public repositories“ oder deine privaten Repositories);
füge es in die Konfiguration ein und liste die zu verfolgenden Repositories auf (besitzer/name, durch Kommas getrennt);
klicke auf „Verbindung testen“, dann füge die Geräte im Tab „Entdeckung“ hinzu.
Screenshots und Diagramme
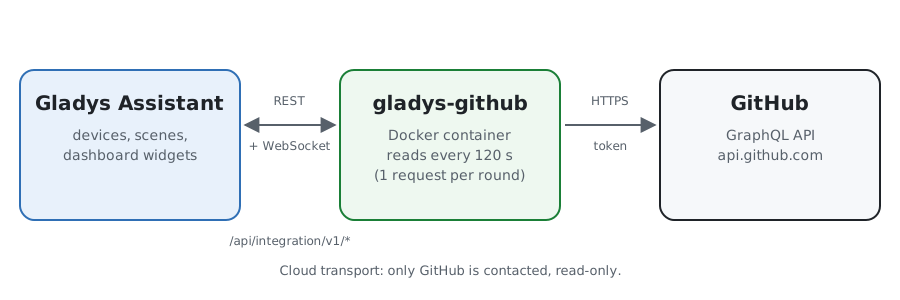
Architekturdiagramm (Illustration)
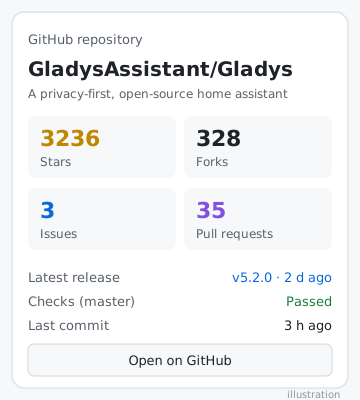
Diese Bilder sind Illustrationen, keine echten Screenshots. [Ort: echte Screenshots der Konfiguration, der Entdeckung, der Widgets und einer Szene zum Hinzufügen.]
Bekannte Einschränkungen
GitHub schiebt nichts ohne öffentlichen Webhook: Die Integration fragt die API standardmäßig alle 2 Minuten ab (von 60 s bis 1 h). Das ist auch die Verzögerung der Auslöser.
Maximal 5 Elemente jedes Typs werden pro Durchlauf gelesen: Ein sehr großer Burst zwischen zwei Durchläufen löst nur die neuesten aus.
GitHub gibt nur die Anzahl der Sterne an, nicht den Autor.
Nichts, was passiert, während Gladys ausgeschaltet ist, wird beim Neustart nachgespielt.
Getestet gegen die echte GitHub-API und das falsche Gladys des SDK. Ich habe es noch nicht in einer echten Gladys-Instanz installiert: Euer Feedback ist willkommen.
Feedback
Eine GitHub-Issue oder eine Antwort in diesem Thread. Gebt die Version von Gladys, die Version der Integration und die Logs der Integration an (ideal mit DEBUG=gladys-integration-sdk).
Danke für das Plugin.
Ich hätte gerne alle meine Integrationen verfolgt, aber sie einzeln einzugeben ist nicht praktisch ^^
Ich habe die Dokumentation befolgt und bekomme nun diesen Fehler, nachdem ich mein PAT eingegeben und die Verbindung getestet habe:
[2026-10-13T07:23:24.628Z] [WARN] GitHub read failed: GitHub refused the query: Resource not accessible by personal access token
Vielen Dank für das Feedback! Beide Punkte sind in der v0.2.0 behandelt (Update verfügbar unter Integrationen → GitHub oder Neuinstallation über die Repo-URL).
Der Fehler „Resource not accessible by personal access token“
Ein feinkörniges Token darf bestimmte Informationen nicht lesen (z. B. die Abonnenten des Kontos oder die CI-Überprüfungen). GitHub lehnte dann die gesamte Anfrage ab. Jetzt erkennt die Integration die
vom Token abgelehnten Informationen, entfernt sie aus der Anfrage und liest den Rest normal: Nur die betroffenen Zähler werden nicht angezeigt. Das Protokoll zeigt an, was entfernt wurde, z. B.:
Not readable with this token, left out: viewer.followers
Wenn du diese Zeile hast, kopiere sie mir: Das sagt mir genau, welches Feld GitHub feinkörnigen Tokens verweigert, und ich kann die Dokumentation präzisieren.
Alle deine Integrationen auf einmal verfolgen
In „Zu überwachende Repos“ kannst du jetzt ein Muster eingeben, anstatt die Repos einzeln aufzulisten:
prohand/* : alle Repos des Kontos (oder einer Organisation);
prohand/gladys-* : nur die, deren Name mit gladys- beginnt;
es kann mit vollständigen Namen gemischt werden: prohand/gladys-*, GladysAssistant/Gladys.
Forks und archivierte Repos werden ignoriert. Die Grenze bleibt bei 20 Repos: Darüber hinaus gehen die vollständig genannten zuerst, dann die zuletzt aktualisierten (der „Testverbindung“-Button zeigt das an). Die Liste wird
alle Stunden neu gelesen, daher erscheint eine neue Integration automatisch im Tab Entdeckung innerhalb einer Stunde.
Die Grenze von 20 kommt von der Konstante MAX_REPOSITORIES = 20 (src/github-api.js:26). Das ist eine Designentscheidung: GitHub schreibt diese Zahl nicht vor. Hier ist, was sie rechtfertigt.
Ein einziger Request pro Durchlauf. Alle überwachten Repositories werden in einem einzigen GraphQL-Request gelesen. Für jedes Repository holt sie die Zähler, die letzten 5 Issues, PRs, Releases und Commits, die letzte Diskussion und den
letzten Tag. Je mehr Repositories, desto schwerer und langsamer wird der Request. GitHub schneidet zu lange Requests ab (etwa 10 s auf ihrer Seite, 20 s Timeout bei uns). Wenn es schneidet, scheitert der gesamte Durchlauf, nicht nur ein
einzelnes Repository.
Die Last auf Gladys. Jedes Repository wird zu einem Gerät mit 14 Funktionen. Mit 20 Repositories haben wir bereits 280 Funktionen, deren Zustände bei jedem Durchlauf veröffentlicht werden (standardmäßig alle 120 s). Das belastet
schließlich die Entdeckung, die Datenbank und die Widgets.
Das GitHub-Kontingent. Ein Token verfügt über 5.000 Punkte pro Stunde. Die Kosten eines Requests steigen mit der Anzahl der angeforderten Verbindungen (releaseAssets(first: 50) in jedem Release zum Beispiel). Mit 20 Repositories bleiben wir bei
einigen Prozent des Kontingents, selbst bei 60 s. So bleibt Spielraum für andere Verwendungen desselben Tokens.
Ein Punkt, der im Vorbeigehen korrigiert werden muss: Die Code-Kommentare (src/github-api.js:7-9) und die Dokumentation besagen, dass ein Request „1 Punkt kostet, unabhängig von der Anzahl der Repositories“. Das ist wahrscheinlich falsch. Nach der Berechnungsregel von
GitHub (angeforderte Verbindungen ÷ 100) würden 20 Repositories eher 3 oder 4 Punkte pro Durchlauf kosten. Ich habe es nicht überprüft, da ich die API hier nicht abfragen kann. Man kann es messen, indem man cost in rateLimit { … } hinzufügt. Selbst in
diesem Fall bleiben wir unter 5 % des Kontingents.
Wenn du den Bedarf über 20 hinaus hast, kann die Grenze erhöht werden (z. B. auf 30 bis 50). Dann müsste man die tatsächlichen Kosten und die Dauer des Requests messen oder ihn in mehrere Requests pro Durchlauf aufteilen.
Ich habe die Messungen durchgeführt: Ich habe die echte Integrationsanfrage auf 100 öffentliche Repositories in zwei Sätzen gestartet. Der erste umfasst Repositories mit durchschnittlicher Größe („gladys“-Repositories), der zweite sehr große, aktive Projekte.
Es ist nicht das GitHub-Kontingent, das blockiert. Die Anfrage kostet etwa 1 Punkt pro 10 Repositories. Selbst mit 100 Repositories, die alle 2 Minuten gelesen werden, würde man unter 7 % der 5.000 Punkte pro Stunde bleiben.
Was blockiert, ist die Dauer der Anfrage. Jedes Repository fügt etwa 200 bis 250 ms hinzu, und GitHub beendet eine Anfrage nach etwa 10 Sekunden:
20 Repositories => 4 bis 6 s => OK
40 Repositories => 7,5 bis 9 s => OK, aber am Limit
60 Repositories => 10 bis 11 s => GitHub-Fehler 502/504
100 Repositories => ~11 s => fast immer fehlgeschlagen
Bei sehr großen, aktiven Repositories ist es noch schlimmer: Ab 15 bis 20 Repositories gibt GitHub einen Teil der Daten leer zurück (RESOURCE_LIMITS_EXCEEDED), vor allem die Download-Zähler der Releases.
Einfaches Erhöhen der Grenze würde daher ganze Abschnitte zum Scheitern bringen. Die richtige Lösung ist, jeden Abschnitt in mehrere kleine Anfragen mit jeweils etwa 10 Repositories aufzuteilen. Jede würde etwa 5 s dauern und 1 Punkt kosten. Damit könnte man auf 50 Repositories kommen und dabei bei etwa 3 % des Kontingents bleiben. Gleichzeitig würde das Problem der leeren Daten bei großen Repositories behoben werden.
Ich kümmere mich darum in einer kommenden Version, ich halte dich auf dem Laufenden!
Es ist mit der v0.3.0 online: Die Integration kann jetzt bis zu 50 Repositories verfolgen, statt 20.
Wie ich dir erklärt habe, kam die Grenze nicht vom GitHub-Kontingent, sondern von der Dauer der Anfrage: GitHub beendet eine Anfrage nach etwa 10 Sekunden. Jetzt liest jeder Durchlauf die Repositories in Chargen von 10, eine kleine Anfrage pro Charge, eine nach der anderen.
Getestet mit der echten GitHub-API und 50 Repositories
Bei 120 Sekunden Intervall entspricht das etwa 3 % der 5.000 Punkte pro Stunde, die GitHub einem Token gewährt.
Es behebt auch einen Bug: Bei vielen großen aktiven Repositories gab GitHub manchmal Daten ohne Vorwarnung zurück, insbesondere die Download-Zähler der Releases. Das passiert nicht mehr mit Chargen von 10.
Die Muster prohand/* profitieren auch von der neuen Grenze. Bei mehr als 50 Repositories werden diejenigen, die du vollständig benannt hast, zuerst bearbeitet, dann die zuletzt aktualisierten.
Aktualisiere die Integration und sag mir, ob bei dir alles hochgeladen wird!