Os presento una integración externa para seguir vuestros repositorios de GitHub desde Gladys.
Qué hace
Cada repositorio seguido se convierte en un dispositivo en Gladys, y tu cuenta también. La integración se inspira en la integración de GitHub de Home Assistant y añade disparadores de escena y widgets. Utiliza la API de GitHub (cloud) con un token de acceso personal en solo lectura: no contacta con nada más y nunca escribe en GitHub. Está pensada para quienes publican código o quieren ser notificados de las nuevas versiones de un proyecto que utilizan.
Funcionalidades
Dispositivo por repositorio: estrellas, forks, seguidores, issues y pull requests abiertas, pull requests fusionadas, discusiones, descargas de la última versión, y en texto la última versión, el último tag, commit, issue, pull request y discusión.
Dispositivo de la cuenta: seguidores, suscripciones, repositorios y gists públicos.
7 disparadores de escena: versión publicada (filtro versión/preversión), issue abierta, pull request abierta, discusión iniciada, nuevo commit, nueva estrella, verificaciones (CI) exitosas o fallidas.
1 acción de escena: leer los números de un repositorio (para un mensaje o una condición).
3 widgets: un repositorio, la actividad reciente, la cuenta con el cupo de API restante.
Algunos ejemplos de escenas:
se lanza una nueva versión de Gladys → mensaje de Telegram con {{triggerEvent.data.summary}};
la CI de mi proyecto falla → la lámpara de la oficina se pone roja;
mi repositorio recibe una estrella → un pequeño sonido en el altavoz.
Instalación
Desde la tienda: estará disponible en el día, el tiempo de la indexación.
O ahora mismo desde la URL del repositorio: Integraciones → Instalar una integración → https://github.com/William-De71/gladys-github.
Se necesita Gladys 5.1.0 como mínimo.
Configuración:
crea un token de granularidad fina en GitHub (acceso « Public repositories » en solo lectura, o tus repositorios privados en lectura);
pégalo en la configuración y lista los repositorios a seguir (propietario/nombre, separados por comas);
haz clic en « Probar la conexión », luego añade los dispositivos en la pestaña Descubrimiento.
Capturas y esquemas
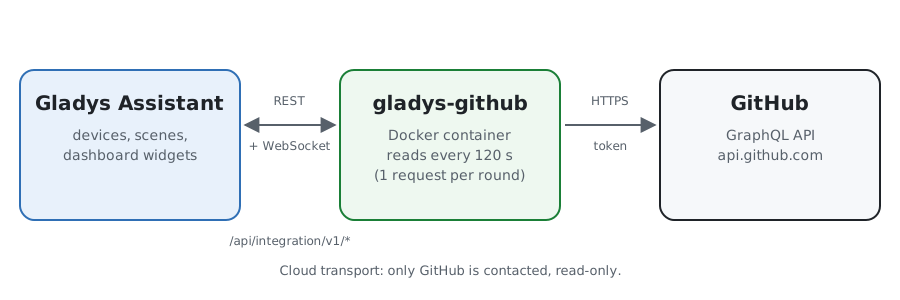
Esquema de arquitectura (ilustración)
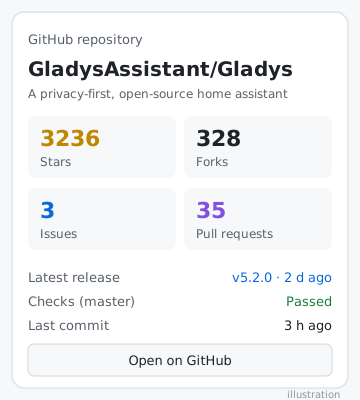
Estas imágenes son ilustraciones, no capturas reales. [Ubicación: capturas reales de la configuración, el descubrimiento, los widgets y una escena para añadir.]
Límites conocidos
GitHub no empuja nada sin webhook público: la integración consulta la API cada 2 minutos por defecto (de 60 s a 1 h). Este también es el retraso de los disparadores.
Se leen como máximo 5 elementos de cada tipo por paso: una ráfaga muy grande entre dos pasos solo dispara los más recientes.
GitHub solo da el número de estrellas, no el autor.
Nada de lo que ocurre mientras Gladys está apagado se reproduce al reiniciar.
Probado contra la API real de GitHub y el falso Gladys del SDK. Todavía no lo he instalado en una instancia real de Gladys: vuestros comentarios son bienvenidos.
Comentarios
Una issue de GitHub o una respuesta en este hilo. Indica la versión de Gladys, la de la integración y los registros de la integración (idealmente con DEBUG=gladys-integration-sdk).
Gracias por este plugin.
Me hubiera gustado seguir todas mis integraciones, pero introducirlas una por una no es práctico ^^
Sin embargo, seguí la documentación y me encuentro con este error cuando pongo mi PAT y pruebo la conexión:
[2026-10-13T07:23:24.628Z] [WARN] GitHub read failed: GitHub refused the query: Resource not accessible by personal access token
¡Gracias por el feedback! Ambos puntos se han tratado en la v0.2.0 (actualización disponible desde Integraciones → GitHub, o reinstalación desde la URL del repositorio).
El error « Resource not accessible by personal access token »
Un token de granularidad fina no tiene permiso para leer cierta información (por ejemplo, los seguidores de la cuenta o las comprobaciones CI). GitHub rechazaba entonces toda la solicitud. Ahora, la integración detecta las
informaciones rechazadas por el token, las elimina de su solicitud y lee el resto normalmente: solo los contadores afectados no se muestran. El registro indica qué se ha eliminado, por ejemplo:
Not readable with this token, left out: viewer.followers
Si tienes esta línea, cópiala para mí: eso me dirá exactamente qué campo GitHub rechaza a los tokens finos, y podré mejorar la documentación.
Seguir todas tus integraciones de una vez
En « Repositorios a seguir », ahora puedes escribir un patrón en lugar de listar los repositorios uno por uno:
prohand/*: todos los repositorios de la cuenta (o de una organización);
prohand/gladys-*: solo aquellos cuyo nombre comienza por gladys-;
se puede mezclar con nombres completos: prohand/gladys-*, GladysAssistant/Gladys.
Los forks y los repositorios archivados se ignoran. El límite sigue siendo de 20 repositorios: más allá de eso, los nombrados por completo pasan primero, luego los más recientemente actualizados (el botón « Probar conexión » lo indica). La lista se
relee cada hora, por lo que una nueva integración aparece sola en la pestaña Descubrimiento en la hora.
El límite de 20 proviene de la constante MAX_REPOSITORIES = 20 (src/github-api.js:26). Es una decisión de diseño: GitHub no impone este número. Aquí está lo que lo justifica.
Una sola solicitud por paso. Todos los repositorios seguidos se leen en una misma solicitud GraphQL. Para cada repositorio, recupera los contadores, las 5 últimas issues, PR, releases y commits, la última discusión y el
último tag. Cuantos más repositorios haya, más pesada y lenta será la solicitud. GitHub corta las solicitudes demasiado largas (alrededor de 10 s por su parte, 20 s de tiempo de espera por nuestra parte). Si se corta, todo el paso falla, no solo
un repositorio.
La carga del lado de Gladys. Cada repositorio se convierte en un dispositivo con 14 funcionalidades. Con 20 repositorios, ya tenemos 280 funcionalidades, cuyos estados se publican en cada paso (cada 120 s por defecto). Al final
satura el Descubrimiento, la base y los widgets.
El cupo de GitHub. Un token dispone de 5,000 puntos por hora. El costo de una solicitud aumenta con el número de conexiones solicitadas (releaseAssets(first: 50) en cada release, por ejemplo). Con 20 repositorios, nos
mantenemos en unos pocos por ciento del cupo, incluso a 60 s. Así mantenemos un margen para otros usos del mismo token.
Un punto a corregir de paso: los comentarios del código (src/github-api.js:7-9) y la documentación dicen que una solicitud cuesta « 1 punto sin importar el número de repositorios ». Probablemente es falso. Según la regla de cálculo de
GitHub (conexiones solicitadas ÷ 100), 20 repositorios costarían más bien 3 o 4 puntos por paso. No lo he verificado, por falta de poder consultar la API aquí. Se puede medir añadiendo cost en rateLimit { … }. Incluso en
este caso, nos mantenemos por debajo del 5 % del cupo.
Si necesitas más de 20, el límite puede aumentarse (30 a 50, por ejemplo). Entonces habría que medir el costo y la duración reales de la solicitud, o dividirla en varias solicitudes por paso.
He realizado las mediciones: he lanzado la verdadera consulta de integración en 100 repositorios públicos, en dos juegos. El primero agrupa repositorios de tamaño estándar (repositorios « gladys »), el segundo de grandes proyectos muy activos.
No es el límite de GitHub lo que bloquea. La consulta cuesta aproximadamente 1 punto por cada 10 repositorios. Incluso con 100 repositorios leídos cada 2 minutos, seguiríamos por debajo del 7 % de los 5,000 puntos por hora.
Lo que bloquea es la duración de la consulta. Cada repositorio añade aproximadamente 200 a 250 ms, y GitHub corta una consulta después de aproximadamente 10 segundos:
20 repositorios => 4 a 6 s => OK
40 repositorios => 7,5 a 9 s => OK, pero al límite
60 repositorios => 10 a 11 s => errores 502/504 de GitHub
100 repositorios => ~11 s => fallo casi siempre
Con grandes repositorios muy activos, es aún peor: a partir de 15 a 20 repositorios, GitHub devuelve parte de los datos vacíos (RESOURCE_LIMITS_EXCEEDED), especialmente los contadores de descargas de las releases.
Aumentar simplemente el límite haría fallar pasajes enteros. La buena solución es dividir cada pasaje en varias pequeñas consultas de una docena de repositorios. Cada una tomaría aproximadamente 5 s y costaría 1 punto. Esto permitiría llegar a 50 repositorios mientras se mantiene alrededor del 3 % del límite. Esto corregiría al mismo tiempo el problema de los datos vacíos en los grandes repositorios.
¡Me encargo de ello en una próxima versión, te mantendré informado!
Está en línea con la v0.3.0: la integración ahora puede seguir hasta 50 repositorios en lugar de 20.
Como te explicaba, el límite no venía del cupo de GitHub, sino de la duración de la solicitud: GitHub corta una solicitud después de aproximadamente 10 segundos. Ahora, cada paso lee los repositorios por lotes de 10, una pequeña solicitud por lote, una tras otra.
Probado en la API real de GitHub con 50 repositorios
A intervalos de 120 segundos, esto representa aproximadamente el 3 % de los 5,000 puntos por hora que GitHub concede a un token.
También corrige un error: con muchos repositorios grandes y activos, GitHub devolvía algunos datos vacíos sin avisar, en particular los contadores de descargas de las releases. Esto ya no ocurre con lotes de 10.
Los patrones prohand/* también se benefician del nuevo límite. Más allá de 50 repositorios, aquellos que has nombrado por completo pasan primero, luego los más recientemente actualizados.
Actualiza la integración y dime si todo se sube bien en tu caso.