Anzeige der Sensorenkurven im Dashboard

Hallo zusammen!

Ich habe diesen Feature-Request erstellt, obwohl er bereits weit fortgeschritten ist, damit wir uns darüber im Forum und nicht nur auf GitHub unterhalten können.

Für den Zeitplan: @euguuu hatte mit einer ersten technischen Spezifikation begonnen und bereits Ende 2020 einen ersten Pull-Request. Das war super umfassend und er ist bei der Recherche sehr weit gegangen!! :slight_smile:

Allerdings war der Pull-Request nicht abgeschlossen, und ich war nicht mit allen technischen Entscheidungen einverstanden, die getroffen wurden. Daher habe ich begonnen, einen anderen Pull-Request von Grund auf neu zu erstellen, basierend auf den gleichen Recherchen, aber mit einer anderen Implementierung.

Ich habe damit diesen Sommer (Mitte Juli) angefangen, und das war keine einfache Entwicklung!

Konkrete Spezifikation für dieses Feature:

  • Anzeige von Sensorwerten in weniger als 50 ms, unabhängig vom Datensatz (auch bei 2 Millionen Sensorwerten)
  • Möglichkeit, die Zeitachse live durch den Dashboard-Nutzer zu ändern
  • Eine super einfache und klare UI
  • Die Hintergrundberechnung der aggregierten Sensorwerte darf Gladys nicht verlangsamen
  • Der Nutzer muss wissen, ob diese Sensordaten aggregiert wurden oder ob etwas schiefgelaufen ist

Bisher sieht es so aus:

https://streamable.com/2utkhd

Die große Herausforderung dieser Entwicklung ist es, die aggregierten Sensorwerte im Hintergrund zu berechnen und dies ohne Gladys zu verlangsamen und in Kommunikation mit dem Nutzer.

Eine neue Ansicht erscheint also in Gladys, die Ansicht „Hintergrundaufgaben“:

Zukünftig ist das Ziel, alle Hintergrundaufgaben (Szenarien usw.) in diese Ansicht zu integrieren, um dem Nutzer mehr Sichtbarkeit darauf zu geben, was im Hintergrund in seinem Gladys passiert.

Mein Pull-Request ist hier verfügbar:

Ich wäre für jedes Feedback dankbar @contributors :slight_smile:

Um mehr Details zur technischen Implementierung zu geben, gibt es nun 3 Arten von Aggregationen:

  • Stündliche Aggregationen: maximal 100 Events pro Stunde gespeichert
  • Tages-Aggregationen: maximal 100 Events pro Tag gespeichert
  • Monats-Aggregationen: maximal 100 Events pro Monat gespeichert

Das Ziel ist es, Anfragen mit unterschiedlichen Zeiträumen beantworten zu können:

  • Gib mir die Temperatur des letzten Jahres (monatliche Daten)
  • Gib mir die Temperatur der letzten 10 Minuten (Live-Daten)
  • Gib mir die Temperatur der letzten 2 Wochen (tägliche Daten)

Was haltet ihr davon?

@Terdious Wenn du ein bisschen Zeit hast (du sagst mir Bescheid :p), wäre es cool, wenn wir das bei dir testen könnten, bevor ich merge. Was hältst du davon? :slight_smile:

Mit großem Vergnügen!! Wir werden die Zeit schon finden!!^^
Können wir sie schon testen?
In puncto Zeitplan (^^), bis wann möchtest du spätestens Feedback haben?

@Terdious Ja, du kannst testen, der Branch ist in einem funktionierenden Zustand!

Wann immer du willst, ich werde nur deployen, wenn es vorher Leute getestet haben, also je eher desto besser :slight_smile:

Ich habe ein erstes Feedback auf GitHub gegeben.

Ich habe meine Produktionsdatenbank wiederhergestellt, aber ich habe nur 24 Stunden Daten und ich weiß nicht warum.

Danke für das super ausführliche Feedback @VonOx!

Bist du sicher, dass die Aggregation gut gelaufen ist? Es ist nicht normal, dass du nur die letzten 24 Stunden hast.

Hast du die Logs?

Tatsächlich habe ich nur 24 Stunden auf meiner Produktionsdatenbank (device_state).

Du hast die DB von prod so konfiguriert, dass sie nur 24 Stunden Daten speichert

Es gibt eine Variable, die die Aufbewahrungsdauer definiert

(Das erinnert mich daran, dass wir diese Variable nirgends anzeigen, ich muss sie irgendwo anzeigen lassen)

Ich gebe zu, ich weiß nicht genau, wie ich da gelandet bin ^^
image

Ich habe den Wert wieder auf 90 gesetzt

Ich habe gerade getestet, wie deine Integration funktioniert, und insgesamt gibt es keine Probleme mit der Funktionalität oder der Benutzeroberfläche. Ich konnte deine Integration nicht wirklich testen, weil meine Produktionsinstanz keine Daten in der Datenbank hat. Es gibt nur die neuesten Daten. Ich habe nichts Besonderes an meiner Produktionsinstanz geändert…

Das ist ein Xiaomi-Sensor, der über Zigbee2mqtt integriert ist.

Ich versuche herauszufinden, warum er nicht mehr Daten speichert…

keep_history ist auf 1… Ich habe das Gefühl, dass ein Bug vorliegt…

Genau das Gleiche! Ich habe auch nach diesem Wert gesucht

2 Leute, die dasselbe Seltsame haben :smiley:

Ja, ich habe auch in der Benutzeroberfläche gesucht und wenn andere dieses Problem haben, wäre es interessant, sie anzuzeigen.

Seltsam, das alles, ich werde mal recherchieren :slight_smile:

Und ja, klar muss man jetzt den Wert in der UI anzeigen, wo wir die Historie nutzen

Zur Information, @VonOx hat mir auf Github ein erstes Feedback gegeben, auf das ich gerade hier geantwortet habe: Add the ability to vizualize device states on the dashboard by Pierre-Gilles · Pull Request #1248 · GladysAssistant/Gladys · GitHub

Viele gute Rückmeldungen, sowohl zu Bugs als auch zu praktischen Verbesserungen, damit die Funktion für den Endnutzer wirklich nützlich ist.

Genau solche Rückmeldungen interessieren mich mehr, ich möchte, dass ihr sagt, ob ihr der Meinung seid, dass es eine nützliche und nutzbare Funktion ist oder ob etwas fehlt.

Das Ziel ist es, etwas zu haben, das gleichzeitig:

  • Sehr ansprechend ist
  • Konfigurierbar und flexibel wie ein Grafana
  • Aber sehr einfach zu bedienen ist, mit Standardwerten, die die Arbeit abnehmen und ein gutes Ergebnis ohne viel Konfiguration liefern

Ich werde also meine Version verbessern und versuchen, eine zweite, korrigierte Iteration vorzuschlagen :slightly_smiling_face:

Kleine Vorschau, woran ich seit heute Morgen arbeite: eine saubere Anzeige von Fehlern in der Ansicht „Hintergrundaufgaben“! :slight_smile:

Ich war schon immer gegen die Anzeige von reinen Logs in der UI (denn wir wissen, was das gibt, dann wird man faul und macht Integrationen, bei denen man die Leute auffordert, IDs in den Logs zu suchen :joy:), andererseits bin ich für eine Ansicht dieser Art, bei der:
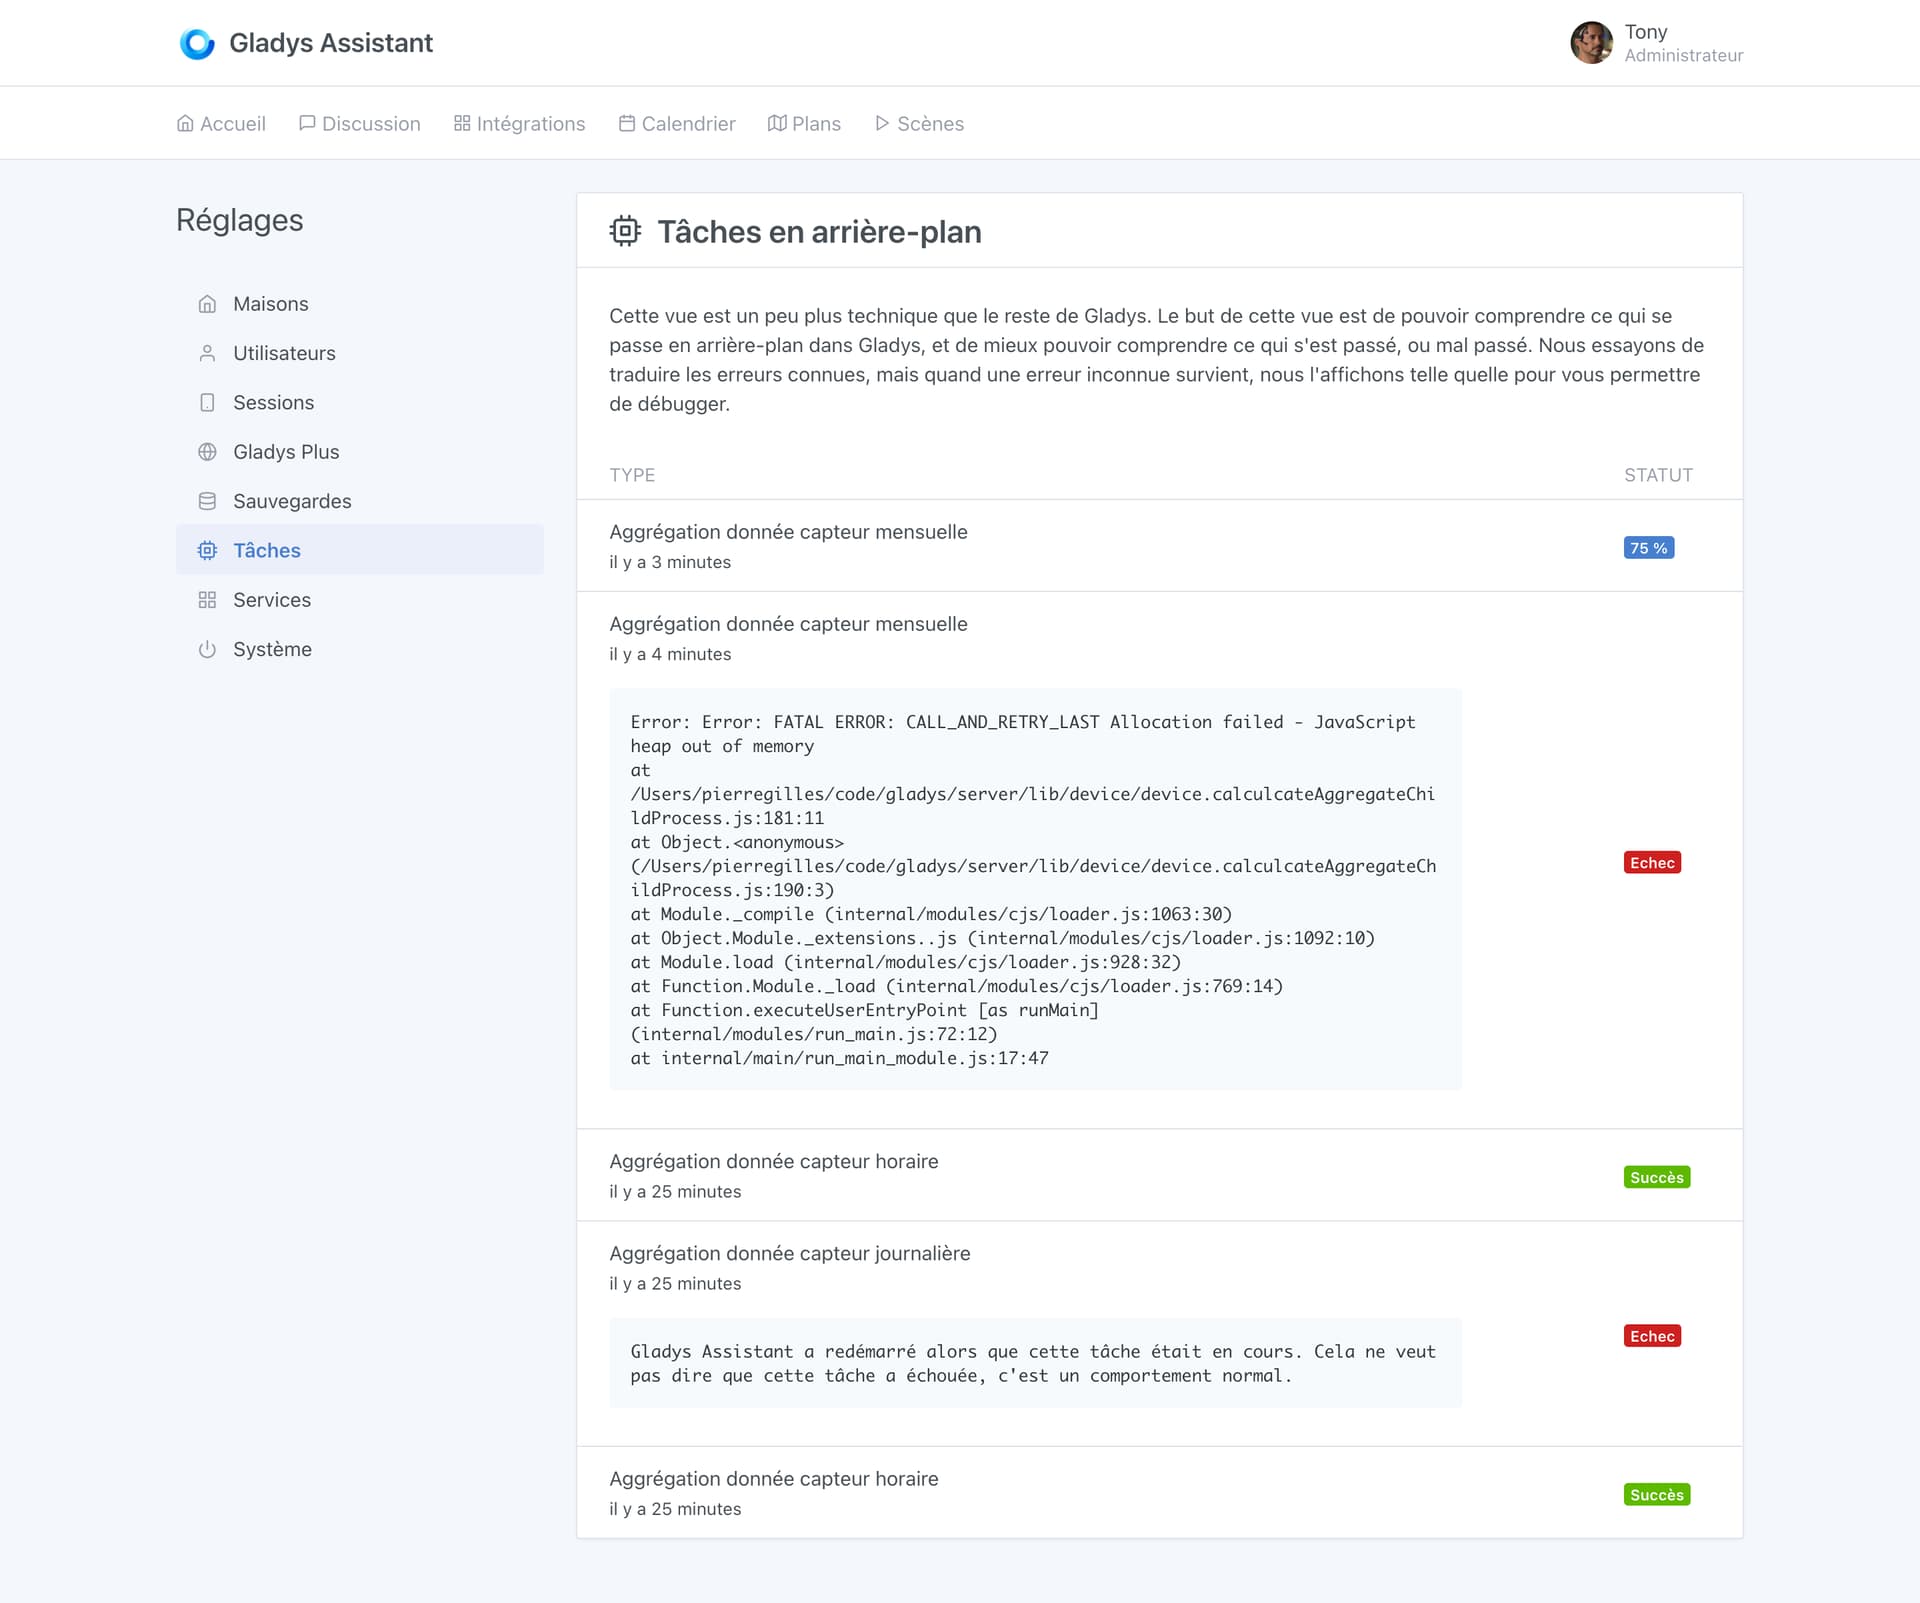
  • Alle bekannten Fehler übersetzt werden und die Vorgehensweise für den Benutzer klar erklärt wird. Beispiel hier mit einem einfachen Fehler: Gladys wurde neu gestartet, während eine Aufgabe lief: das ist ein normales Verhalten, und das sollte man klarstellen.
  • Bei unbekannten Fehlern wird dieser direkt angezeigt, damit der Benutzer uns Feedback geben kann, dann gibt es zwei Lösungen:
    • Es ist ein Bug, wir beheben den Bug
    • Es ist ein Fehler, der unter bestimmten Bedingungen auftreten kann (kein Bug): Beispiel „OUT_OF_MEMORY“/„DISK FULL“, etc… In diesem Fall fügen wir diesen Fehler der Liste der übersetzten Fehler hinzu, mit einer klaren Nachricht und einer Anleitung zur Fehlerbehebung.

So sieht die Ansicht derzeit aus:

Was haltet ihr davon? :slight_smile:

Es ist Morgen :smirking_face:

Es ist klar, weil der Fehler im Zusammenhang mit der Aufgabe steht.

Ein Zugriff auf das vollständige Log wäre ein Pluspunkt (das erspart dem Benutzer das SSH), aber das ist ein anderes Thema.

:joy:

Das ist die vollständige Fehlermeldung.

Im Fall der Sensoraggregation wird Node.js als Single-Thread verwendet, und ich wollte den Haupt-Gladys-Thread nicht blockieren. Daher wird die Aggregation in einem separaten Worker durchgeführt.

Das hier angezeigte Log ist das vollständige Fehlerlog, das vom Worker gesendet wird. Daher gibt es nichts weiter zu sehen per SSH :slight_smile:

In jedem Fall sollte normalerweise kein Fehler auftreten. Ich habe das genau für den Fall hinzugefügt, dass wir mal etwas falsch machen oder jemand mit einer riesigen Datenbank auf eine technische Begrenzung seiner Maschine stößt (damit wir es sehen), aber normalerweise sollte dieser Fall nicht sehr häufig eintreten.

Ich sprach eher vom allgemeinen Log, du aber vom Fall der Hintergrundaufgaben.

Meine Idee war eher für alles, was Dienste usw. betrifft.
Deshalb sagte ich, dass es ein anderes Thema ist.

Der nächste Schritt für mich, und das ist eine Hintergrundaufgabe, ist das Hinzufügen der Szenenausführung zu dieser Ansicht.

Das Ziel ist es, zu sehen, was passiert ist:

  • Warum wurde ein Trigger validiert? Oder nicht?
  • Der Ausführungsplan der Szene und die verschiedenen Bedingungen, die validiert wurden oder nicht

Danach wird das außerhalb dieses Pull Requests sein.