Kamera-Bildqualität in Szenenaktionen

Ich möchte, dass die KI ein Bild analysiert (das Bild meines Fußbodenheizungsmanometers, falls Sie diesem Diskussion gefolgt sind :wink: ), aber ich stelle fest, dass die Antwort der KI ziemlich zufällig ist, und ich denke, dass dies an der Qualität des Bildes liegen könnte, das in der Aktion « KI fragen » bereitgestellt wird.

Ich gehe davon aus (zu bestätigen durch @pierre-gilles), dass das Bild, das der KI bereitgestellt wird, dasselbe ist wie das, das man mit der Aktion « Kamera-Bild senden » erhält.

Mit dieser Aktion « Bild senden… » erhalte ich zum Beispiel dieses Bild:

Wenn ich jedoch auf meinem Dashboard bin, das dasselbe Bild anzeigt, erhalte ich dieselbe Bildqualität, aber ein deutlich besseres Bild, wenn ich auf das Symbol image klicke, um den Live-Stream anzuzeigen.

Das Basisbild auf dem Dashboard:


Das Bild im Live-Stream:
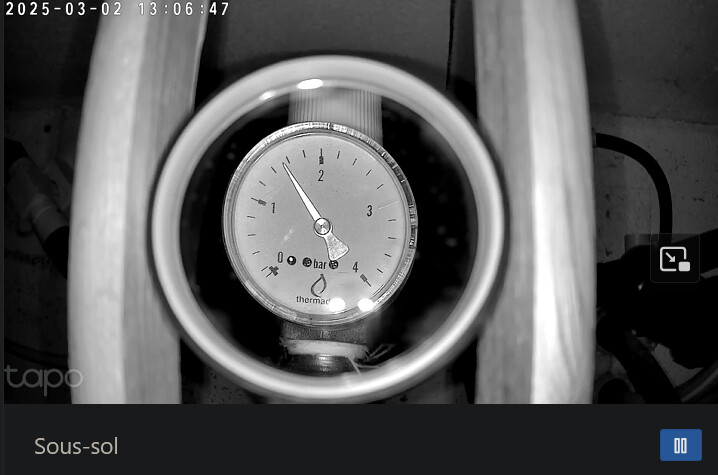
Muss ich etwas Besonderes tun, um die Qualität des an die KI gesendeten Bildes in einer Szene zu verbessern?

Zur Klarstellung: Es handelt sich um eine Tapo C200-Kamera, und der in der Kamera-Integration konfigurierte Stream hat das Format rtsp://benutzername:passwort@IP:port/stream1, wobei stream1 bei Tapo dem HD-Bild entspricht.

Ich habe gerade deine verschiedenen Fotoqualitäten mit Perplexity getestet und jede Antwort war identisch (und falsch): etwa 1,4 bar.
Und als ich ihm die Wahrheit entlockt habe, bin ich auf 1,55 bar gekommen, aber es musste mit mehreren Fragen angepasst werden, indem ich ihm sagte, dass es zwischen 1,4 und 1,6 bar liegen muss und er interpolieren müsse.
Naja, diese KIs sind nicht toll…

mit etwas mehr Arbeit (und vor allem habe ich Perplexity genau gefragt, was zu tun ist), würde man einen solchen Prompt erhalten:

Analysiere das Bild des Manometers. Das Manometer hat eine Skala von 0 bis 4 bar. Zwischen jeder Zahl (0, 1, 2, 3, 4 bar) gibt es 4 Striche. Jeder Strich entspricht 0,2 bar.

: Bestimme, zwischen welchen Hauptzahlen (0, 1, 2, 3, 4) sich die Nadel befindet.

: Zähle die Anzahl der vollen Striche (jeweils 0,2 bar) nach der letzten Hauptzahl, die die Nadel überschritten hat. Wenn die Nadel zwischen zwei Strichen steht, schätze ihre relative Position zwischen diesen beiden Strichen (z. B. „leicht danach“, „halbwegs“, „kurz davor“ usw.).

: Berechne den Druck, indem du den Wert der letzten überschrittenen Hauptzahl und den Wert der gezählten Striche addierst. Wenn die Nadel zwischen zwei Strichen steht, füge eine Schätzung des Bruchteils des Strichs hinzu.

    : Gib den geschätzten Druck in bar an (z. B. „Der Druck beträgt geschätzt X,XX bar“).

Sei präzise in deiner Analyse und begründe jeden Schritt deiner Überlegungen.

Ergebnis:

Danke @mutmut für die Tests. Ich hatte tatsächlich nicht daran gedacht, direkt im KI-Tool zu testen, um zu sehen, ob die Bildqualität etwas ändert. Ich habe gerade einen ähnlichen Test wie deinen in chatGPT durchgeführt (da es die KI ist, die Gladys verwendet) mit dem folgenden Prompt:

Analysiere das Bild des Manometers, das eine Skala von 0 bis 4 Bar hat. Zwischen jeder Hauptteilung mit einer Zahl (0, 1, 2, 3, 4 Bar) gibt es Zwischenstriche, die 0,2 Bar darstellen. Bestimme, wo sich der Zeiger befindet, und leite daraus den Druck ab. Gib mir schließlich den geschätzten Druck in Bar an, mit einem Satz im folgenden Format: « Der Druck wird auf X.X Bar geschätzt ».

Mit dem Bild schlechter Qualität erhielt ich zunächst eine perfekte Antwort: « Der Zeiger des Manometers scheint leicht unter der 2-Bar-Marke zu stehen, genauer gesagt bei etwa 1,8 Bar. Der Druck wird auf 1,8 Bar geschätzt. » Dann habe ich eine zweite identische Anfrage gestellt, und diesmal erhielt ich die Antwort « Der Zeiger des Manometers zeigt zwischen 1,0 und 1,2 Bar, leicht vor der 1,2-Bar-Marke. Der Druck wird auf 1,1 Bar geschätzt. » Schließlich erhielt ich bei einer dritten Anfrage, aber mit einem Bild guter Qualität, die Antwort « Laut Bild zeigt der Zeiger des Manometers leicht unter der 1,0-Bar-Marke, bei etwa 0,9 Bar. Der Druck wird auf 0,9 Bar geschätzt. »

Zusammengefasst: Keine Zuverlässigkeit :wink: . Ich denke, ich sollte dabei bleiben, dass Gladys mir das Bild sendet und dass meine nicht künstliche Intelligenz sich die Mühe macht, den Druck abzulesen :joy:

Aber trotzdem würde ich gerne, dass Gladys mir das Bild in guter Qualität schickt und nicht ein verschlechtertes Bild… Ich weiß nicht, ob ich etwas tun muss oder ob es eher eine Anpassung in der Entwicklung von Gladys ist…

Ich stimme zu :rofl:

Und für den Prompt, man sollte so viele wie möglich verwenden, wie ich es gemacht habe, das hat mir eine KI gesagt :zwinkern:

Hallo @StephaneB :slightly_smiling_face:

Das auf dem Dashboard angezeigte und über Telegram an die Benutzer gesendete Bild ist auf eine maximale Breite von 640px begrenzt.

Das ist seltsam, das Bild, das du teilst, scheint größer zu sein, aber das könnte eine von Telegram angewendete Bearbeitung sein. Wenn du das Bild direkt von deinem Dashboard herunterlädst, sollte es maximal 640px breit sein!

Der Videostream hingegen ist in 1080p, also breiter.

Das ist nicht in Stein gemeißelt, wir könnten die Qualität erhöhen, aber wir müssten den Einfluss auf die Flüssigkeit der Anwendung testen und sicherstellen, dass es gut im über WebSocket an die Frontends gesendeten Nachricht funktioniert.

Was die KI betrifft

Gladys verwendet das Modell ChatGPT-4o mini, mit einer Bildqualität, die auf „low“ (max. 512px breit) eingestellt ist. Je größer das Bild, desto länger und teurer ist die Verarbeitung durch ChatGPT.

Aber hier scheint das Problem nicht die Bildqualität zu sein. Wie du in deinen Tests festgestellt hast, neigt die KI eher dazu, „Halluzinationen“ zu haben, als die Nadel nicht zu sehen. Solange die Nadel gut sichtbar ist, sollte die KI sie korrekt analysieren können.

Ich denke, man sollte eher deinen Prompt verfeinern, präziser und knapper sein. Es ist eine ausgezeichnete Idee, direkt auf ChatGPT außerhalb von Gladys zu testen :slightly_smiling_face:

Danke für die Präzisierung. Ich werde vor meiner Rückkehr zu Gladys noch mehr Tests in chatGPT durchführen, falls ich etwas Zufriedenstellendes erhalte.

Ich nutze die Gelegenheit: idealerweise, wenn ich eine gute Interpretation durch die KI erhalte, möchte ich, dass die KI den Wert in ein MQTT-Gerät schiebt, um ihn dann im weiteren Verlauf der Szene zu nutzen oder um einen Wertverlauf zu speichern.
Ist das bereits umsetzbar, und falls ja, wie muss man das in der Eingabeaufforderung an die KI formulieren? Was ich verstanden habe, ist, dass man der KI derzeit eine Szene starten lassen kann, oder ein Licht ein- oder ausschalten, oder eine Steckdose ein- oder ausschalten, aber ich würde gerne eine Bestätigung haben :wink:

Das ist nicht machbar! Das Einzige, was du eventuell tun kannst, ist, sie zu bitten, ein Licht (virtuell) einzuschalten, wenn etwas zu tun ist.

Beispiel:

Wenn der Druckmesser unter 1,8 liegt, schalte das virtuelle Bürolicht ein

Dann erstellst du einen Raum „virtuelles Büro“, in dem du ein falsches Licht platzierst, und erstellst eine Szene, die auf das Einschalten des falschen Lichts reagiert.

Das ist weit hergeholt, aber das ist die einzige Möglichkeit, die es derzeit gibt :slight_smile: