Lassen Sie uns über Gladys V4 sprechen

Ok, also los geht’s! Ich lösche mein Repo und klone es neu, sobald es auf deiner Seite fertig ist!

Aber wenn jede Person, die für Gladys entwickeln will, daran denken muss, ihr Git neu zu konfigurieren, wird es sicherlich Probleme geben :stuck_out_tongue:
Hoffentlich müssen wir nicht so weit kommen…

Erledigt! Du kannst es neu klonen :slight_smile:

Ja, aber das ist etwas extrem Grundlegendes in der Entwicklung, 100% aller Softwareprojekte haben dieses Problem, und alle ernsthaften Projekte überprüfen das.

Ich würde mich wundern, wenn es keine Lösung gäbe.

Okay, dann los geht’s!

Das Problem ist dank der berühmten Datei .gitattributes behoben! Danke @MathieuA, dass du das gefunden hast, zumindest wird es jetzt für Windows-Entwickler funktionieren :slight_smile:

@MathieuA ich würde gerne deine Meinung zur neuen Architektur/Art und Weise, Gladys und die Controller zu laden, hören.

Ansonsten habe ich die Typprüfung mit JSDoc + Typescript CLI aktiviert (ohne Typescript zu schreiben, nur durch die Verwendung von Kommentaren).

Ach ja, wegen dieser Geschichte hatte ich keine Zeit, um mal reinzuschauen!

Nicht schlecht die Sache mit den Klassen! Effektiv ist das schöner als require in jeder Datei ^^

Allerdings verwirrt mich ein bisschen, dass es ein lib- und ein api-Verzeichnis gibt. Vor allem, weil ich es persönlich genau andersrum gemacht hätte :stuck_out_tongue:
Im api-Verzeichnis hätte ich den Kern von Gladys untergebracht, denn das erscheint mir ein bisschen logischer (wenn man das so sagen kann). Aber das ist eine persönliche Präferenz :slight_smile:

Ich bin derselben Meinung.

Alternativ können wir lib in core umbenennen…

Oder wir legen das Verzeichnis core direkt in api

api
----- controllers
----- core
----- middlewares
----- routes.js
----- index.js

Und dann api in lib umbenennen :stuck_out_tongue:

lib
----- controllers
----- core
----- middlewares
----- routes.js
----- index.js

Ehrlich gesagt, bin ich gerade zu anderen Repositories gegangen, ich habe api und lib gesehen, das schockiert mich eigentlich nicht so sehr.

Für mich ist lib wirklich der Gladys-Kerncode, und api ist die REST-API.

Ja, ich denke, das ist eher Geschmackssache. Es gibt keine echte Best Practice!
Es ist dein Projekt, also entscheidest du. Wenn du damit zufrieden bist, dann ist es okay ^^

Ich mag es, externe Meinungen zu hören, das ist wichtig :slight_smile: Wir fangen so an und sehen uns dann die anderen Rückmeldungen an.

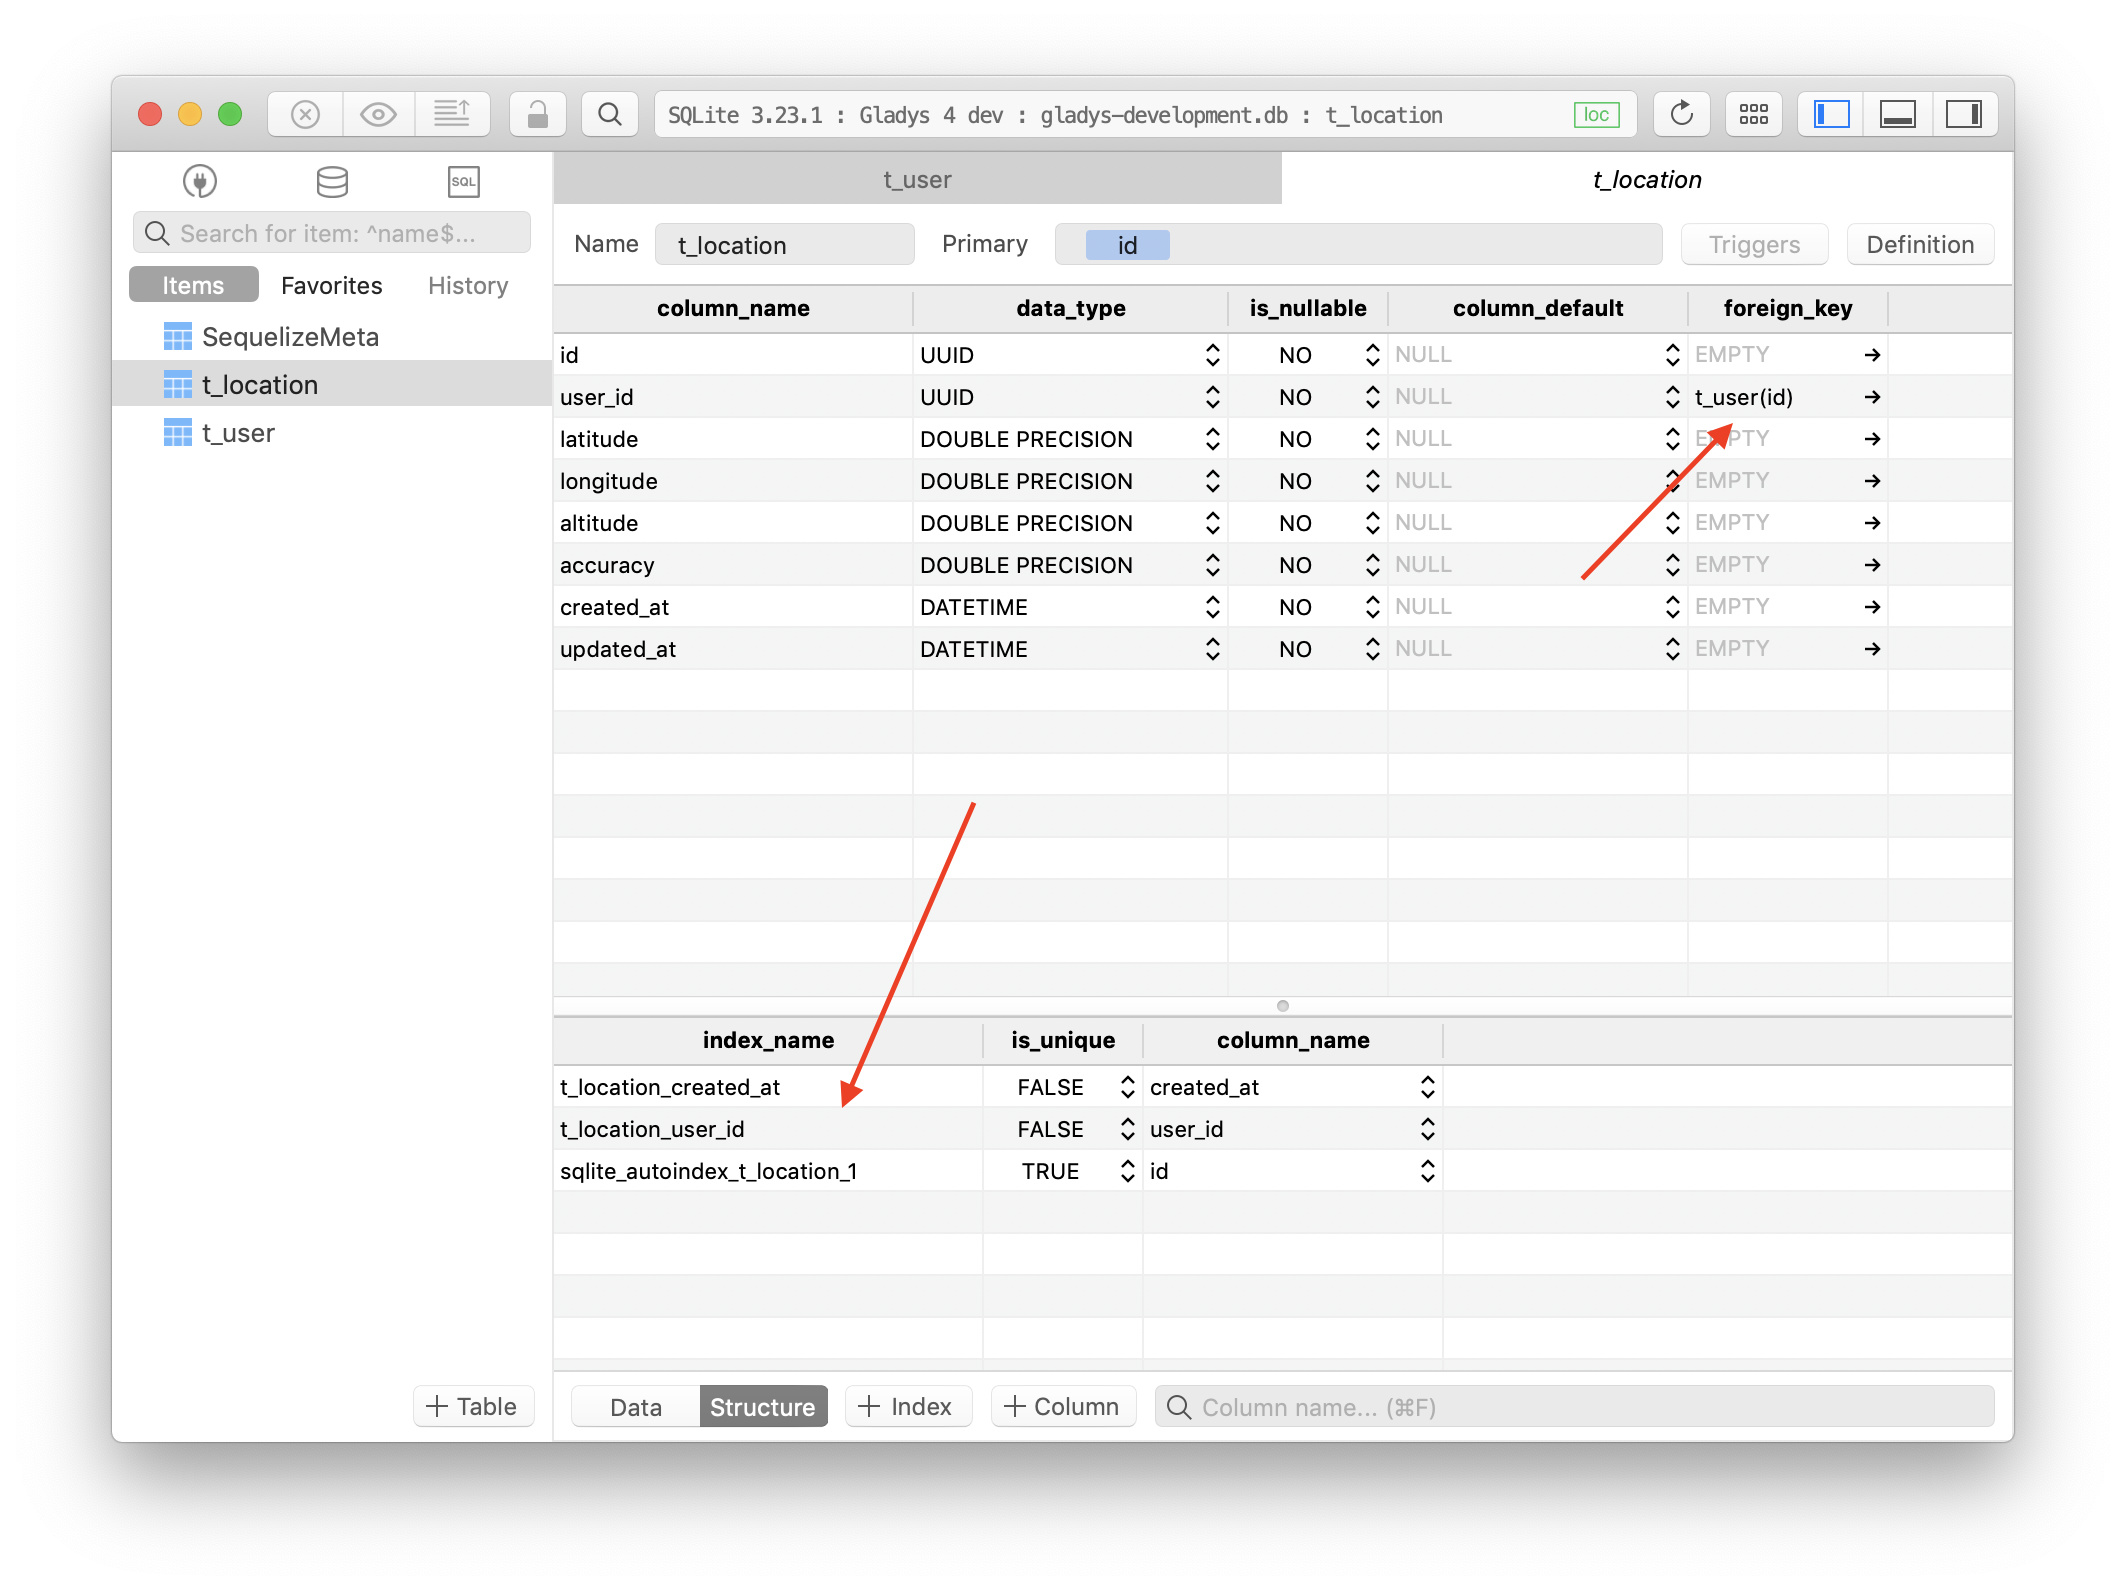
Raah die Indizes + Foreign Keys mit Sequelize sind der Hammer

Das ist mega schwer :open_mouth:

Ich habe das README des Gladys 4 Playground Repos mit allen Installationsanweisungen zum Testen aktualisiert :slight_smile:

Zögert nicht, es bei euch zu testen!

https://github.com/GladysAssistant/gladys-4-playground

Falls ihr ein gutes Tool zum Erkunden von SQLite-Datenbanken sucht, empfehle ich TablePlus:

Oder sqliteonline.com für diejenigen, die keine Lust haben, etwas zu installieren :stuck_out_tongue:

Ehrlich gesagt, nicht schlecht die Struktur, sehr klar! Kleine Frage, ich sehe, dass du « joi » verwendest, warum nicht direkt nur die Constraints von Sequelize verwenden?

Ich denke, die Constraints von Sequelize werden nicht für alles ausreichen, ich denke insbesondere an die Validierung von Objekten in Szenen oder Triggern, die verschachtelte JSON-Objekte sein werden.

Danach hast du recht, es könnte sich lohnen, diese zusätzliche Validierung in einer Funktion im Modell zu testen :slight_smile: Guter Hinweis, ich werde es mir ansehen.

Frage zur Sicherheit: In deinem Manifest habe ich gesehen, dass du gesagt hast, dass man die Bibliotheken gut auswählen sollte, die nicht kaputt sind. Aber ich habe den Eindruck, dass du kein System implementiert hast, um zu überprüfen, ob diese Bibliotheken eines Tages tatsächlich kaputt sind!

Vielleicht wäre es interessant:

  • ein automatisches Skript zu implementieren, das npm audit überprüft und die Informationen per E-Mail sendet
  • ein System zu implementieren, das dies automatisch erledigt (pm2 macht das in seiner kostenpflichtigen Version, glaube ich)

Aber es ist kompliziert, es bei jedem einzurichten? Oder nur bei einigen Entwicklern? Es ermöglicht möglicherweise, Sicherheits-Patches durchzuführen, falls erforderlich.

Außerdem sollte man, denke ich, jeden Modulentwickler zwingen, « Best Practices » zu befolgen, z. B. jedes Mal zu überprüfen, ob ein bestimmtes Modell zuvor validiert wurde, dass man z. B. nur eine E-Mail-Adresse im E-Mail-Adressenfeld einfügen kann und keinen Code / XSS usw. injizieren kann.

Dafür ist es super einfach:

1/ GitHub macht bereits automatische Checks!
2/ Es gibt Greenkeeper (https://greenkeeper.io/), der das automatisch erledigt. Ich habe es im aktuellen Gladys-Repo verwendet, aber ich hatte so viele Benachrichtigungen wegen Sails, das ein Nest von veralteten Abhängigkeiten ist, dass ich es deaktiviert habe. Ich werde es in Gladys 4 wieder aktivieren! :slight_smile: Greenkeeper erstellt tatsächlich die PRs selbst, sobald eine Bibliothek aktualisiert werden muss!

Vollkommen einverstanden!

Die Schutzmaßnahmen werden durch zwei Dinge festgelegt

1/ Die Technologien, die wir verwenden. Beispiel: Auf der Frontend-Ebene erlaubt Preact keine XSS-Lücken, es verwaltet die Anzeige der Variablen und alles wird von der Bibliothek gereinigt, damit es richtig gemacht wird.

2/ Die statische Code-Analyse. Das ist die Aufgabe der sehr strengen Regeln, die ich in ESLint festgelegt habe, die einen konsistenten und „aseptischen“ Codierungsstil erzwingen und eine Reihe von Checks durchführen, um die Codequalität zu garantieren. (Das fängt eine unberechenbare Anzahl von Fehlern/Sicherheitslücken ab)

3/ Selbstverständlich die Unit- und Integrationstests. Es liegt an uns, sehr feine Tests zu schreiben und eine hohe Code-Abdeckung zu erreichen, um sicherzustellen, dass nichts Unbeabsichtigtes möglich ist. Großer Vorteil, wir schreiben die Tests ab dem ersten Tag, daher können wir leicht eine Code-Abdeckung von > 90% erreichen und robust sein. Ein weiterer großer Vorteil ist, dass das Einbinden interner Module in den Kern das Schreiben von Tests für Module sehr einfach macht und somit die gleichen Garantien für Module wie für den Kern bietet.

Hallo zusammen!

Ich bin mit der Modellierung gut vorangekommen, fast alle Modelle sind definiert:

https://github.com/GladysAssistant/gladys-4-playground/tree/master/server/models

Bei der Datenbank sind die Migrationen gut vorangekommen, mir fehlen nur noch die Indizes und dann bin ich fertig! :slight_smile:

Ich habe tatsächlich teilweise deine Überlegungen verwendet, ich habe mich von deinem GitHub-Repo inspirieren lassen (ich hatte es im Blick!), als ich daran gearbeitet habe :slight_smile: Ich hatte nur den Link zur Tabelle verloren, danke!

1/ Ich verstehe immer noch nicht, warum man Kategorien + Unterkategorien braucht! Wenn der Sinn von Kategorien/Unterkategorien nur darin besteht, in der UI ein Dropdown-Menü mit Kategorien und Unterkategorien zu haben, dann ja, das ist das, was ich vorhabe :slight_smile: Aber das ist nur die UI. Die Datenbank ist eine Darstellung einer Modellierung, zwei Felder vom Typ « Kategorie » « Unterkategorie » hier einzufügen, würde das etwas bringen? In Bezug auf strenge Modellierung, wenn man ein Attribut in zwei Attribute aufteilt, dann möchte man, dass eine Unterkategorie zu mehreren Kategorien gehören kann. Nicht unbedingt das, was wir wollen, oder? (offene Frage, sag mir Bescheid, wenn du ein Gegenbeispiel hast, ich bin offen dafür! :slight_smile: ).

2/ Eine der Werte, die ich in das Manifest gesetzt habe, ist, dass für Gladys 4 « wir nicht alles machen, aber was wir machen, machen wir gut ».

In Gladys 3 bin ich zu oft in alle Richtungen gegangen (um « sicherzustellen », dass der Fall behandelt wird), es gibt Kategorien, die zu nichts nützen, die Typen waren offen, wir hatten « Sätze », die mit nichts verkabelt waren. Kurz gesagt: Ich habe mir zu viel vorgenommen, und hinter vielen statischen Daten war kein Code verkabelt. Und das war dumm, weil der Benutzer den Satz sieht und denkt « cool, ich kann XX behandeln », und in Wirklichkeit: nein!

Hier habe ich die « Mindestbasis » der Kategorien aufgelistet, die ich sehe. Schritt für Schritt, wenn Module (die ich erinnere, im Core sein werden) hinzugefügt werden, werden wir nach und nach Kategorien hinzufügen. Aber solange wir nichts haben, warum Kategorien einfügen, wenn wir sie nicht verwalten können? :slight_smile:

3/ Was wir beim Entwicklertreffen besprochen haben, war:

DeviceFeature

  • type: Bestimmt in der UI, welcher Button verwendet wird. « binary » wird zu einem Ein/Aus-Button, « multilevel » zu einem Slider, « color » zu einem Farbauswahlfeld.
  • category: Hilft Gladys zu verstehen, « was das Objekt ist », und eine angemessene Darstellung in der UI auf Ebene des Icons zu setzen. Hilft auch dem Brain, alle Geräte einer Kategorie zu finden. « Schalte die Wohnzimmerlichter ein », « Wie warm ist es im Badezimmer? », « Ist die Garagentür offen? », « Senke die Temperatur in der Küche », usw…

Wenn du dir Anwendungen von Unterkategorien vorstellen kannst (außer, dass es für den Entwickler organisiert ist, hier ist es eine Modellierung, das ist pragmatisch, was wir tun! :stuck_out_tongue: ), sag mir Bescheid, es ist tatsächlich ein Thema, das man besser jetzt klären sollte!

PS: Aber ja, man kann den Drucksensor hinzufügen, er muss ohnehin hinzugefügt werden, sobald man in Gladys 4 ein Modul hinzufügt, das ihn erstellen muss :slight_smile: