Ich habe mich mit @AlexTrovato und @VonOx darüber unterhalten, da die Veröffentlichung bald ansteht, müssen wir unseren Entwicklungsprozess ändern, um vor jeder Veröffentlichung mehr Tests einzuführen.
Bevor wir über dieses Thema diskutieren, nur eine Einschränkung, die wir haben:
Die Release-Builds von Docker-Images für ARM-Plattformen sind extrem langsam (ca. 1 Stunde), und wir können nicht unbegrenzt viele davon durchführen. Ich kenne die Grenzen von CircleCI nicht, aber einige Builds pro Woche/Monat sind in Ordnung, mehrere Builds pro Tag sind nicht möglich.
Wir können also nicht sagen, dass wir systematisch einen Branch (master? dev?) bauen, es muss eine manuelle Aktion sein, um zu sagen: « Wir möchten einen DEV-Build durchführen, damit jeder diese Pre-Release testen kann ».
@AlexTrovato Ich überlasse dir das Wort, wenn du Vorschläge hast
Äh hallo, ich stelle mich vor, ich heiße… nein, wir haben uns ja schon vorgestellt
Ich denke, es könnte interessant sein, einen « testing »- oder « pre-release »-Zweig zu haben, der sozusagen den aktuellen Modus fortsetzt, eine Kandidatenversion, die maximal getestet werden muss (wir wissen ja, dass es schwierig ist, alles zu testen, besonders wenn man sich mit Hardware verbindet…).
Kurz gesagt, wir sollten im Modus der Bilderzeugung pro neuer Dienst bleiben, mit maximalen Tests, um Feedback zu korrigieren, ohne sich die Finger zu verbrennen.
Ich sage « pro neuer Dienst », aber wenn wir genug Tester finden, könnten wir bis zu 3 Dienste gehen; aber ich denke auch, dass es wichtig ist, den Umfang zu begrenzen.
Das bedeutet, dass wir maximal ein Bild pro Tag hätten (weil auch Zeit benötigt wird, um das Feedback zu bearbeiten).
Also:
Warten auf die Integration von N neuen Funktionen (Dienste oder Kern)
Erzeugen eines Bildes mit einem Umfang, der auf diese N Funktionen begrenzt ist (+ andere Fehler, falls vorhanden)
Wir können uns einem Agile + Git Flow-Prozess annähern:
Bereitstellung einer Arbeitsmenge für eine begrenzte « Dauer / Umfang » (mit einer Aufgabenliste)
Integration dieser Neuerungen in einen dev-Zweig aus den PRs
Validierung (je nach Verfügbarkeit) der Neuerungen (aufgelistet) eine nach der anderen
Wenn alles in Ordnung ist, wird alles in master integriert
eine neue Version ist geboren
Der Erfolg kommt mit guter Organisation.
Ich rede und rede, aber eure Meinungen interessieren mich.
Hallo ihr beiden,
Ich verstehe nicht ganz, was ihr meint, und das ist normal, ich habe keine Kenntnisse in der Softwareentwicklung.
Aber könntet ihr bitte genauer erklären, was ihr mit Folgendem meint:
Braucht ihr Tester für bestimmte Funktionen oder bestimmte Hardware, bevor ihr sie endgültig in Gladys integriert?
Falls ja, wäre es vielleicht interessant, eine Liste der verfügbaren Benutzer und der Hardware, die sie besitzen, zu erstellen, um Tests durchführen zu können.
Ja, ich mag die Idee der Materialliste.
Ich gehe davon aus, dass, wenn du dein Material angibst, du möchtest, dass es in Gladys integriert wird, und dafür muss es getestet werden.
Ich bin dafür.
Was den Dialog zwischen Alex und Pierre-Gilles angeht, verstehe ich auch nicht alles. Aber es ist interessant, dieses Thema zu lesen, denn meistens sind diese Gespräche privat und Nicht-Entwickler können nicht teilnehmen und ihre Meinung äußern.
Es wäre tatsächlich gut, einen Testzweig zu haben, um neue Funktionen/Entwicklungen zu validieren, bevor sie in den Hauptzweig integriert werden.
Aber sollten wir sie nach Dienstleistungen aufschlüsseln? Ich glaube nicht, denn sonst testen wir nicht die potenziellen Nebeneffekte auf die anderen in Entwicklung befindlichen Dienste.
Es wäre auch gut, einen Zweig zu haben, um die auf der Release entdeckten Fehler schneller zu beheben => Git flow
Ich bin auch dafür, Aufgabenlisten zu definieren, die mit PRs verbunden sind und nach Meilensteinen zu integrieren, aber ich merke, dass es schwierig ist, agil zu sein, wenn man nur abends daran arbeitet…
wenn wir einen flexiblen Weg hätten, um festzulegen, welche PRs in die nächste Release integriert werden, abhängig von der Entwicklung unseres Zeitplans, wäre das super.
Übrigens, ich habe ein nettes Bug-Sammel-Tool gefunden, das Node unterstützt. Es gibt einen großen Artikel darüber im Linux Magazin Sonderheft, das gerade erschienen ist:
Grundsätzlich bin ich dafür. Aber was mir bei diesem Ansatz Angst macht, ist, dass dieser Zweig zu einem „Alles-Mögliche“-Zweig wird, und dass wir irgendwann in einer Situation sind, in der wir zum Beispiel 2 Features haben, die bereit zum Mergen sind, und die durch ein „verrottetes“ Feature blockiert werden, das das Mergen verhindert.
Zum Beispiel: Stell dir vor, du arbeitest an der PR Sonoff HTTP, und jemand arbeitet an der PR Zigbee2mqtt.
Wenn wir beide in „pre-release“ setzen, aber eine der beiden einen kritischen Bug einführt, der lange dauert, um behoben zu werden, dann ist die PR Sonoff blockiert (und der gesamte Entwicklungsfluss mit). Dort, wo wir in unserem aktuellen Ansatz „pro Feature individuell pro Zweig“ arbeiten.
Ich wäre interessiert zu sehen, wie große Open-Source-Projekte, die unserem Use-Case nahe sind, das machen (ich denke zum Beispiel an Home Assistant, sie haben viele Beitragende).
Ja, ich verwende das auf vielen Projekten. Allerdings ist es für Cloud-Projekte geeignet, aber nicht für selbstgehostete Open-Source-Projekte.
1/ Es sendet alle deine Daten an Sentry, das ist das Gegenteil der Projektphilosophie
2/ Abgesehen von den Preisen/Begrenzungen. Es ist überhaupt nicht für unseren Use Case gemacht
Wenn du kannst, können wir über den Teil Fehlerverfolgung/Telemetrie in einem anderen Thema sprechen. Es ist ein Thema, dem ich nicht abgeneigt bin, aber es muss gut gemacht werden und mit vielen Vorsichtsmaßnahmen, um die Privatsphäre der Gladys Assistant-Nutzer zu respektieren.
Um auf die Prozesse großer Open-Source-Projekte vergleichbarer Größe einzugehen, hier ist, wie Home Assistant vorgeht:
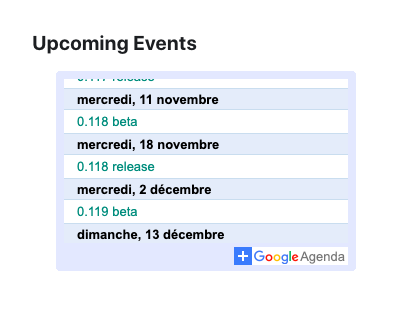
Ein « dev »-Branch, der unserem Master-Branch entspricht. Alle PRs werden in diesen Branch gemerged, und einmal pro Woche wird ein « beta »-Image gebaut. Ich nehme an, dass einige Power-User Home-Assistant Beta statt der « prod »-Version laufen lassen.
Ein Master-Branch, der die Prod-Version ist. Alle zwei Wochen rebasen sie den « master »-Branch auf den dev-Branch. (Master wird zum Inhalt von dev, der normalerweise seit einer Woche über den beta-Tag getestet wird.)
Ich finde das nicht schlecht, aber meine Frage ist: Was passiert, wenn es ein großes Problem in ihrem dev-Branch gibt?
Außerdem sehe ich am Ende wenig Unterschied zu unserem aktuellen Flow.
Wir mergen die PRs in master (der ihrem dev entspricht). Dann fehlt uns nur noch eine manuelle CI-Aufgabe, um master zu bauen, wenn wir es brauchen (zu einem Docker-dev-Tag), und wenn wir bereit sind, machen wir ein versioiniertes Tag, damit es in die Produktion geht!
Genau, ein PR sollte nur gemerged werden, wenn es wirklich perfekt funktioniert.
Ach übrigens, das erinnert mich daran, dass es cool wäre, wenn jeder PR mindestens ein amd64-Build in den automatischen Tests durchläuft, um sicherzustellen, dass das Docker-Image immer perfekt funktioniert. (Ich sage amd64, weil das schnelle Builds sind, wenn wir ARM-Builds testen müssen, dauert das viel länger.) Derzeit sind wir ein bisschen blind, wenn wir den Docker-Teil mergen. @VonOx, was denkst du?
Nein, wir sind vorerst nicht auf CircleCI umgestiegen!
Sie haben dazu kommuniziert:
CircleCI hat sich mit Docker zusammengetan, um sicherzustellen, dass unsere Nutzer weiterhin auf Docker Hub ohne Rate Limits zugreifen können. Ab dem 1. November sollten Sie, mit wenigen Ausnahmen, bei der Nutzung von Docker Hub über CircleCI nicht von Rate Limits betroffen sein.
Diese Rate Limits könnten jedoch in Zukunft für CircleCI-Nutzer in Kraft treten. Deshalb ermutigen wir Sie und Ihr Team, Docker Hub-Authentifizierung zu Ihrer CircleCI-Konfiguration hinzuzufügen und ggf. Ihren Docker Hub-Tarif zu aktualisieren, um zukünftige Auswirkungen von Rate Limits zu vermeiden.
Ja, das ist natürlich keine langfristige Lösung, aber vorerst funktioniert es
Für mich ist es klar, dass sie eine Lösung für Open-Source-Projekte in Bezug auf die Rate Limits umsetzen werden, denn wir sind sicher nicht die Einzigen, die dieses Problem haben.
Was die Builds und Pushes in den PRs angeht, bin ich voll und ganz damit einverstanden, dass wir immer noch das Problem mit den Secrets haben, aber ich denke, dass es mit nur amd64-Builds funktioniert!